Explication
Cerveau d’entreprise : ce que c’est et comment en construire un pour vos agents IA
Un cerveau d’entreprise (company brain) est la mémoire commune du fonctionnement de votre entreprise, tenue à jour et structurée pour que les personnes et les agents IA puissent la lire et s’y fier. Voici ce qu’il doit faire, comment se comparent les approches courantes, et comment en construire un sous forme de documents markdown entretenus par vos agents, avec Knowtarium pour garder la trace de ce qu’ils écrivent.
Par Fadel Kaadan · Mis à jour le
Qu’est-ce qu’un cerveau d’entreprise ?
Un cerveau d’entreprise (en anglais, company brain) est la mémoire écrite et partagée du fonctionnement d’une entreprise : ses décisions, ses définitions, ses processus, ses clients et ses leçons, tenue à jour et structurée pour que les personnes comme les agents IA puissent la trouver, la lire et s’y fier.
C’est la réponse à des questions comme « qu’est-ce qu’un client actif chez nous ? », « pourquoi avons-nous abandonné l’offre gratuite ? » ou « qui s’occupe de l’export de facturation ? ». D’habitude, ces réponses vivent dans la tête de quelqu’un, dans un fil de discussion du printemps dernier et dans trois pages de wiki qui se contredisent. Un cerveau d’entreprise met une seule réponse à jour à un seul endroit, et note d’où elle vient.
Ce qu’un cerveau d’entreprise n’est pas :
- Pas un modèle. Le cerveau, c’est la connaissance. Le chatbot ou l’agent qui répond aux questions à partir de lui n’est qu’une interface posée dessus.
- Pas un tas de tout. Indexer chaque e-mail et chaque message vous donne une recherche, pas une mémoire. Un cerveau garde la version distillée : la décision, pas les 200 messages qui y ont mené.
- Pas une application de notes personnelles. Un second cerveau sert la réflexion d’une seule personne. Un cerveau d’entreprise est partagé, donc l’exactitude, la responsabilité et la relecture comptent plus que la vitesse de saisie.
Dans Knowtarium
Knowtarium est une base de connaissances chiffrée de bout en bout que les personnes et les agents IA écrivent ensemble, conçue pour ce genre de cerveau : des documents markdown rangés en espaces de travail et en dossiers, qui montrent chacun qui l’a écrit (et, dans les dossiers où la relecture est activée, qui l’a vérifié). Vous pouvez commencer gratuitement. Pour l’instant, un espace de travail appartient à une seule personne : le partage avec une équipe n’existe pas encore.
Pourquoi le terme s’est imposé
Les entreprises veulent une source unique de vérité depuis qu’il existe des wikis. Ce qui a changé, c’est qui la lit. Les agents IA écrivent désormais du code, répondent aux clients, rédigent des rapports et mènent des analyses, et chacun d’eux a besoin du contexte de l’entreprise pour bien le faire.
Une personne contourne le contexte manquant : elle demande à un collègue, se souvient du trimestre dernier, remarque qu’un chiffre semble faux. Un agent ne fait rien de tout cela. Il connaît ce qui se trouve dans sa fenêtre de contexte et rien d’autre, et la plupart des agents repartent de zéro à chaque session. La documentation de Claude Code le dit clairement : chaque session commence avec une fenêtre de contexte vierge, et ce qui est conservé, c’est ce qui est écrit dans des fichiers, comme CLAUDE.md ou AGENTS.md. Si le contexte n’est pas écrit, l’agent devine.
La deuxième raison, c’est que les wikis se dégradent. La note LLM Wiki d’Andrej Karpathy, publiée en avril 2026, résume le problème en une phrase :
« Les humains abandonnent les wikis parce que le coût de leur entretien grandit plus vite que leur valeur. »
Sa proposition : laisser le modèle tenir les comptes. Un agent lit les sources brutes, écrit et met à jour des pages markdown reliées entre elles, et les vérifie régulièrement pour repérer contradictions, affirmations périmées et pages orphelines. Les personnes font le tri et posent les questions. Cette idée, des agents qui entretiennent la connaissance au lieu de seulement la chercher, est ce qui distingue un cerveau d’entreprise du wiki que vous avez déjà. (Notre guide du wiki LLM détaille ce modèle.)
Le terme s’est répandu à partir de là. Il recouvre aujourd’hui aussi bien des wikis hébergés avec recherche IA que des projets open source qui gardent la mémoire d’un agent sous forme de fichiers markdown dans git. Ils diffèrent surtout sur la question que la note de Karpathy laisse aux personnes : qui vérifie ce que les agents ont écrit.
Ce qu’un cerveau d’entreprise doit faire
Quel que soit l’outil, un cerveau d’entreprise a quatre missions. La plupart des installations remplissent assez bien les trois premières. C’est sur la quatrième qu’elles diffèrent le plus, et c’est elle qui décide si quelqu’un se fie aux réponses.
1. Capter ce qui compte
La connaissance doit entrer sans que quelqu’un la recopie à la main : comptes rendus de réunion, décisions, tendances du support, rapports d’incident, changements de prix ou de processus. En pratique, ce sont des agents qui lisent la matière brute et écrivent ou mettent à jour le document concerné.
2. Rester à jour
Un cerveau qui avait raison en mars est dangereux en septembre, parce qu’il paraît tout aussi sûr de lui. Chaque fait qui peut changer a besoin d’une date après laquelle quelqu’un le revérifie, et d’un moyen de retrouver tout ce qui en dépend le jour où il change.
3. Pouvoir être interrogé par les personnes et les agents
Les personnes doivent pouvoir le parcourir et y chercher. Les agents doivent pouvoir le lire sans intégration spéciale pour chaque outil : du texte brut, une structure prévisible, de courtes descriptions qu’ils peuvent survoler avant d’ouvrir un document entier.
4. Être digne de confiance
Quand les agents écrivent une grande partie du contenu, chaque document doit répondre d’emblée à quatre questions :
- Qui l’a écrit ? Une personne, ou un agent (et lequel) ?
- Qui l’a vérifié ? Une personne l’a-t-elle relu, ou seulement un autre agent, ou personne ?
- D’où vient-il ? Quelle source appuie chaque affirmation ?
- Est-il toujours vrai ? Quand a-t-il été confirmé pour la dernière fois, et quand expire-t-il ?
Sans cela, le cerveau se remplit peu à peu de textes plausibles que personne n’a vérifiés, et l’on finit par ne plus se fier à rien. Une réponse d’IA qui cite un document vieux d’un an et jamais relu est pire que pas de réponse du tout, parce qu’elle a l’air de faire autorité.
Dans Knowtarium
Hormis un Web Clipper qui enregistre des liens, Knowtarium laisse la capture à vos agents et met tout son poids sur la quatrième mission. Qui a écrit un document, d’où il vient et quand il expire figurent en haut de la page, et les documents qui ont dépassé leur date sont listés sur la page Stale and expiring. Dans les dossiers où la relecture est activée, la page montre aussi qui l’a vérifié, et le graphe peut colorer les documents par niveau de confiance (unverified, machine-confirmed ou human-reviewed). Les personnes font des recherches en texte intégral dans l’application, et les agents lisent les mêmes documents via MCP.
Trois façons de construire un cerveau d’entreprise
Wiki hébergé et recherche IA
La voie la plus courante : garder (ou adopter) une base de connaissances hébergée et y ajouter une couche IA qui cherche dedans et dans vos autres outils. Les produits de cette catégorie diffèrent par leur portée et par ce que leur IA a le droit de modifier :
- Recherche d’entreprise. Se connecte à des centaines d’applications de travail (messagerie, disques partagés, outils de tickets, CRM) et répond aux questions à travers elles, en ne montrant à chacun que ce qu’il a le droit de voir.
- Wikis avec assistant intégré. Répondent aux questions à partir du wiki et de quelques applications connectées, et laissent leurs agents créer et modifier des pages.
- Wikis qui s’entretiennent seuls. Surveillent vos autres outils, rédigent une mise à jour quand une page devient obsolète et la soumettent à une personne pour approbation.
Points forts : les permissions, la prise en main par des équipes non techniques, la recherche dans tout à la fois, aucune installation pour la plupart des gens. Points faibles : la connaissance vit dans la base de données d’un éditeur, et les agents de code qui travaillent dans un dépôt y accèdent en général par une API ou un serveur MCP au lieu de la lire directement. La recherche dans les sources brutes trouve aussi facilement le fil de discussion contradictoire que la réponse arrêtée.
Base vectorielle et RAG
Les équipes d’ingénierie construisent souvent la leur : découper les documents, calculer leurs embeddings, stocker les vecteurs et récupérer les morceaux les plus proches au moment de la question (génération augmentée par récupération, ou RAG). C’est souple et cela tient sur des corpus énormes.
Points forts : les grandes collections qui changent vite ; les pipelines sur mesure. Points faibles : personne ne peut lire une base vectorielle. Les contradictions cohabitent, la récupération renvoie le morceau qui obtient le meilleur score, et il n’y a pas d’endroit naturel pour noter qui a vérifié un fait ni quand il expire. Vous finissez par construire une couche de relecture par-dessus de toute façon.
Des fichiers markdown dans git, lus directement par les agents
L’approche à laquelle les équipes de développement sont arrivées d’elles-mêmes : la connaissance est un dossier de fichiers markdown dans un dépôt. Claude Code, Codex, Cursor et d’autres agents lisent et modifient les fichiers avec les mêmes outils que pour le code. Un fichier de conventions (AGENTS.md, un format ouvert que agents.md présente comme pris en charge par Codex, Cursor et de nombreux autres agents de code, ou le CLAUDE.md de Claude Code) leur explique comment le dossier est organisé. C’est la forme du wiki LLM de Karpathy.
Points forts : les agents peuvent le lire et l’entretenir sans aucune intégration, chaque changement est un diff que vous pouvez relire, git vous donne l’historique et le blame gratuitement, et rien n’est enfermé chez un éditeur. Points faibles : pas de permissions au-delà de celles du dépôt, pas d’éditeur soigné pour les collègues non techniques, et git seul ne vous dit pas quels documents une personne a vérifiés.
| Wiki hébergé + recherche IA | Base vectorielle / RAG | Markdown dans git | |
|---|---|---|---|
| Où vit la connaissance | Dans le cloud de l’éditeur | Dans votre base de données, en vecteurs | Dans des fichiers texte qui vous appartiennent |
| Les agents la lisent via | API, MCP ou assistant intégré | Votre code de récupération | Le système de fichiers |
| Les agents y écrivent | Selon le produit | Via votre pipeline d’ingestion | Oui, comme on modifie du code |
| Relecture des changements | Variable selon le produit | À construire soi-même | Diffs, pull requests |
| Permissions | Par utilisateur, par document | À construire soi-même | Par dépôt |
| Idéal pour | Les grandes organisations ou les organisations peu techniques | Les corpus énormes, les produits sur mesure | Les équipes dont le travail passe déjà par des agents et git |
Aucune de ces approches n’est mauvaise. Si vous avez des centaines de salariés, des règles d’accès strictes et peu de gens qui ouvrent un terminal, un wiki hébergé vous servira mieux. La suite de cette page porte sur la troisième approche, parce que c’est celle où les agents font l’entretien. Knowtarium s’appuie sur elle : les mêmes documents markdown et le même frontmatter, dans un espace de travail chiffré de bout en bout auquel vos agents accèdent via MCP.
Construire un cerveau d’entreprise en fichiers markdown entretenus par vos agents
Vous pouvez démarrer en un après-midi avec un dépôt git et l’agent de code que vous utilisez déjà. Les étapes ci-dessous suivent l’Open Knowledge Format (OKF), une spécification ouverte publiée par Google Cloud (v0.2 sur GitHub) pour la connaissance en markdown écrite par des agents. Le format ne dépend d’aucun outil, et tant qu’une ou deux personnes seulement touchent au dossier, les diffs git et un œil attentif peuvent suffire. La plupart des étapes indiquent ce que Knowtarium ajoute.
1. Commencez par un seul domaine douloureux
N’essayez pas de capturer toute l’entreprise. Choisissez les questions qu’on pose le plus souvent ou auxquelles on répond le plus souvent de travers : prix et limites des offres, définitions des indicateurs, processus de mise en production, runbooks d’astreinte. Un cerveau qui a raison sur dix sujets vaut mieux qu’un cerveau qui a vaguement raison sur mille.
2. Créez le dépôt et une arborescence
Une notion par fichier, regroupées dans des dossiers qui ont du sens pour votre équipe :
company-brain/AGENTS.md # les règles que suivent les agents dans ce dossierindex.md # ce qu’il contient, une ligne par documentlog.md # ce qui a changé, le plus récent en premiercompany/glossary.md # ce qu’on entend par « client actif », « churn », « MRR »decisions/2026-08-pricing.md # une décision par fichier, avec sa raisonproduct/plans-and-limits.mdrelease-process.mdmeetings/2026-08-14-pricing-review.mdcustomers/segments.mdaccounts/northwind.mdrunbooks/refunds.mdon-call.md
index.md et log.md sont des noms réservés dans OKF : le premier liste ce que contient un dossier, le second note ce qui a changé. Les agents lisent l’index en premier, et n’ouvrent ainsi que les documents dont ils ont besoin.
Dans Knowtarium
Importez ce dossier dans un espace de travail Knowtarium et c’est un paquet OKF tel quel : les dossiers suivent, et les documents auxquels il manque des champs s’ouvrent quand même. Le graphe, la recherche et la vue des propriétés fonctionnent à partir des mêmes documents que ceux que modifient vos agents.
3. Écrivez les règles pour vos agents
Mettez les conventions dans AGENTS.md (et faites pointer CLAUDE.md vers lui si vous utilisez Claude Code). Restez bref et précis. Notre guide AGENTS.md pour les bases de connaissances en propose une version plus complète.
# Règles de cette base de connaissances- Une notion par fichier. Cherche avant de créer ; mets plutôt à jour le fichier existant.- Chaque fichier commence par un frontmatter : type, title, description.- Quand tu écris ou modifies un fichier, mets generated.by à ton nom d’agent et à ta version.- Ne t’ajoute jamais à verified, ni personne d’autre. Seuls les relecteurs le font.- Chaque affirmation factuelle cite une source dans une note de bas de page : [^source-id].- Donne une date stale_after aux faits qui changent vite (prix, responsables, limites).- Relie les documents liés par des liens markdown depuis la racine du paquet : [Churn](/metrics/churn.md).- Ajoute une ligne à log.md pour chaque changement : date, fichier, quoi et pourquoi.
Dans Knowtarium
Connectez Claude Code, Codex ou Cursor avec et Knowtarium lui transmet les conventions de base avec ses outils : lire d’abord l’index.md de l’espace de travail quand il en a un, lire les descriptions avant les documents entiers, et ne jamais marquer quoi que ce soit comme vérifié par une personne. Chaque changement qu’il fait est signé avec sa propre clé. Écrivez votre AGENTS.md dans l’espace de travail lui-même, pour tout l’espace ou pour un dossier, et chaque agent connecté le suit pour chaque document qu’il y écrit.
4. Notez la provenance dans chaque document
C’est le frontmatter qui rend le cerveau digne de confiance. OKF définit des champs pour exactement les quatre questions ci-dessus : generated (qui l’a écrit, et quand), verified (qui l’a vérifié), sources (d’où viennent les affirmations) et stale_after (quand il faut le revérifier).
---type: Decisiontitle: Les offres annuelles offrent deux moisdescription: Pourquoi le prix annuel vaut 10 fois le mensuel, et quand le revoir.status: stablegenerated: { by: claude-code/2.1, at: 2026-09-20T09:12:00Z }verified:- { by: human:sara, at: 2026-09-21T14:30:00Z }stale_after: 2027-03-31T00:00:00Zsources:- id: pricing-reviewresource: /meetings/2026-08-14-pricing-review.mdauthor: human:sara---Les offres annuelles coûtent dix fois le prix mensuel.[^pricing-review]Nous revoyons ce choix à la fin du T1, une fois les chiffres de churn connus.
Les auteurs sont nommés sous une forme fixe : un agent avec sa version (claude-code/2.1), une personne (human:sara) ou un processus (process:billing-sync). Un lecteur peut alors déduire le niveau de confiance d’un document de la liste verified au lieu de se fier à une étiquette. Voir comment faire citer leurs sources aux agents pour la convention des notes de bas de page.
Dans Knowtarium
Knowtarium affiche ce frontmatter sous forme de propriétés en haut du document plutôt qu’en YAML brut. Vos propres clés, comme un champ owner, sont conservées exactement telles quelles.
5. Alimentez-le avec ce que vous avez déjà
Donnez à un agent votre export de wiki, vos comptes rendus de réunion ou un dossier de décisions, et demandez-lui d’écrire un document par notion en citant le fichier source de chaque affirmation. Attendez-vous à des doublons et à des contradictions au premier passage. C’est utile : ils vous montrent où votre documentation actuelle se contredit.
Dans Knowtarium
Chaque document que l’agent écrit pendant cette phase est signé de son nom et n’a aucune entrée verified tant que quelqu’un ne l’a pas vérifié : les documents importés ne passent donc jamais pour des documents vérifiés, et chacun peut être annulé. Si vos notes sont dans un coffre Obsidian, importez-le dans un espace de travail et il est converti en OKF sans toucher à ce que vous avez écrit.
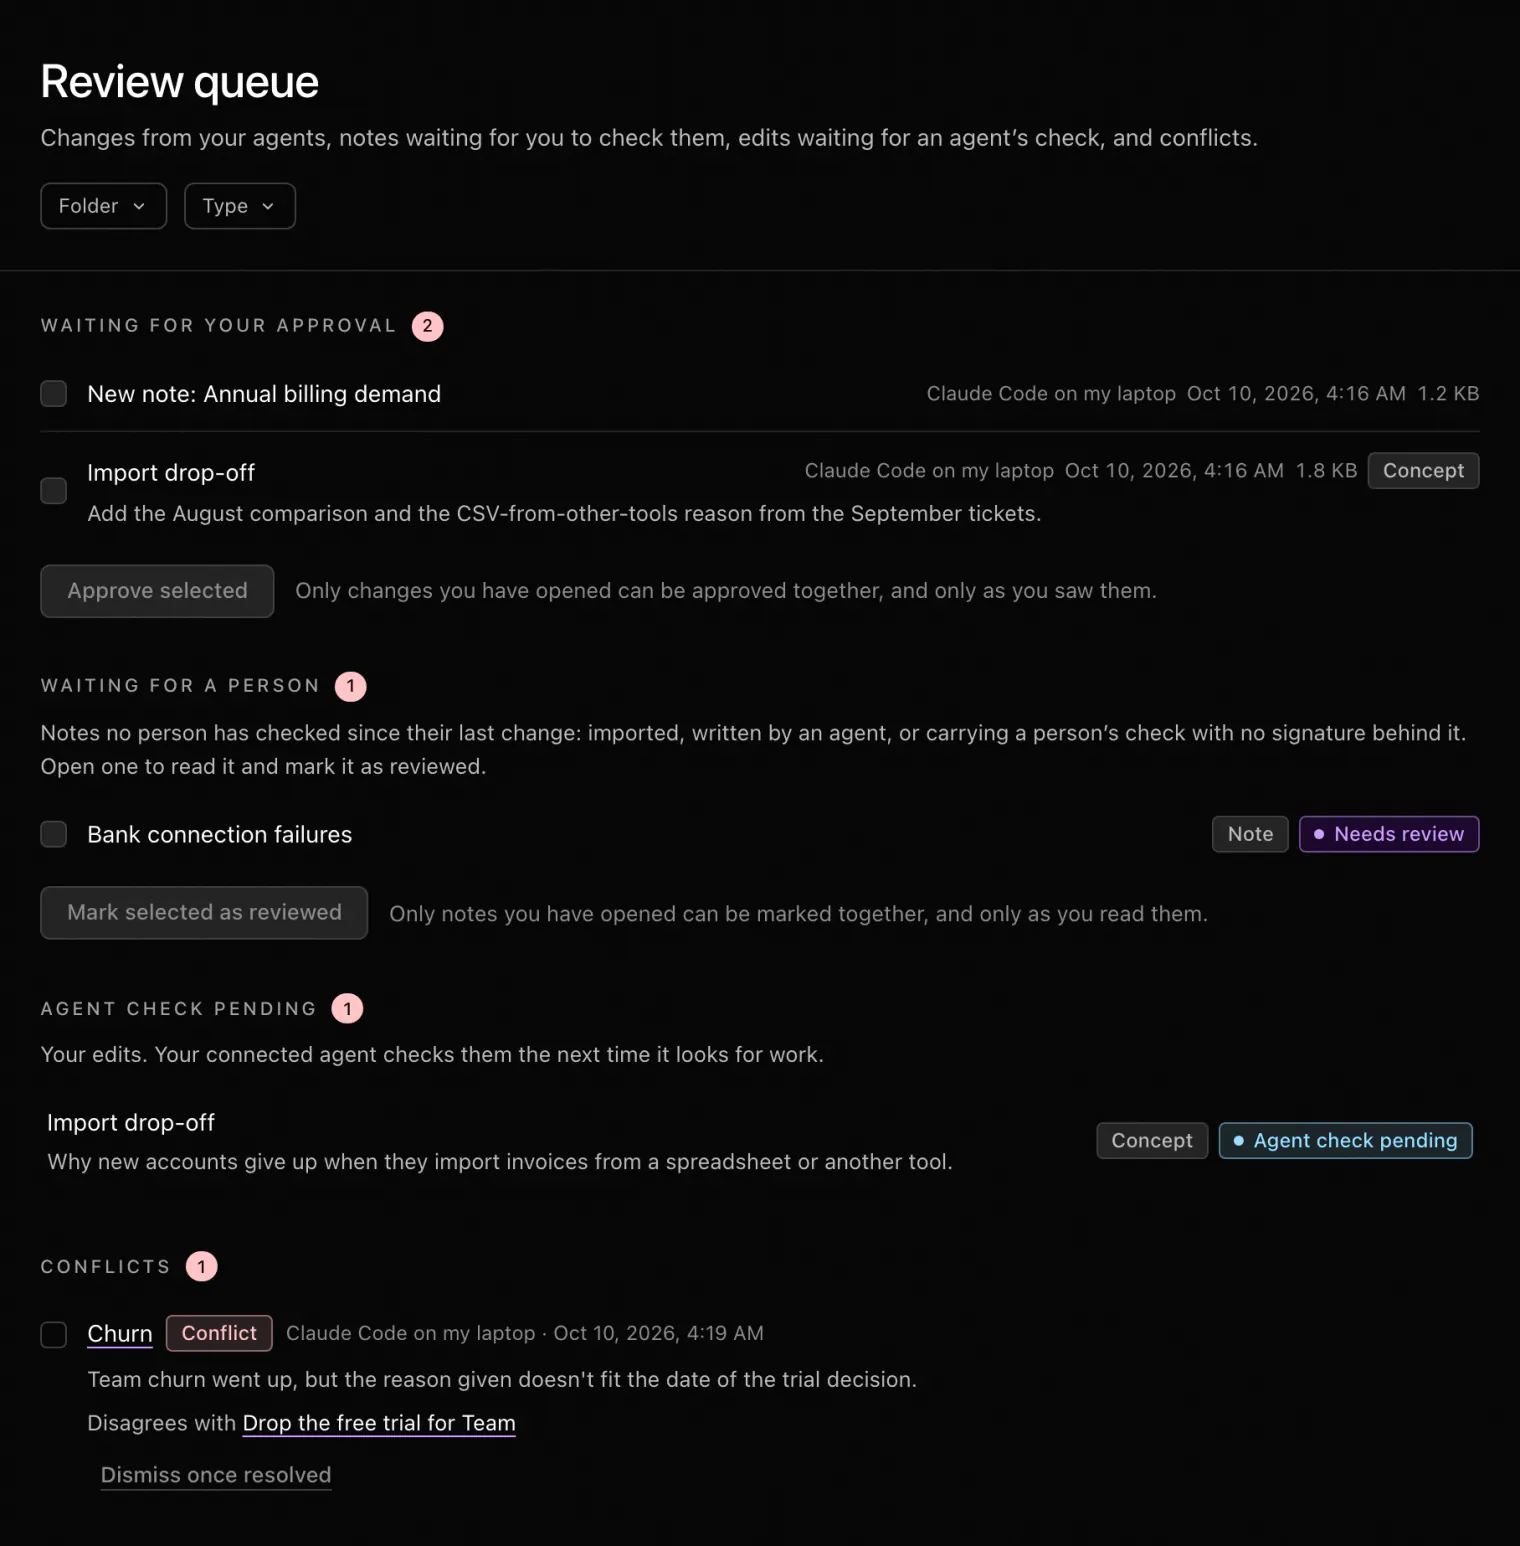
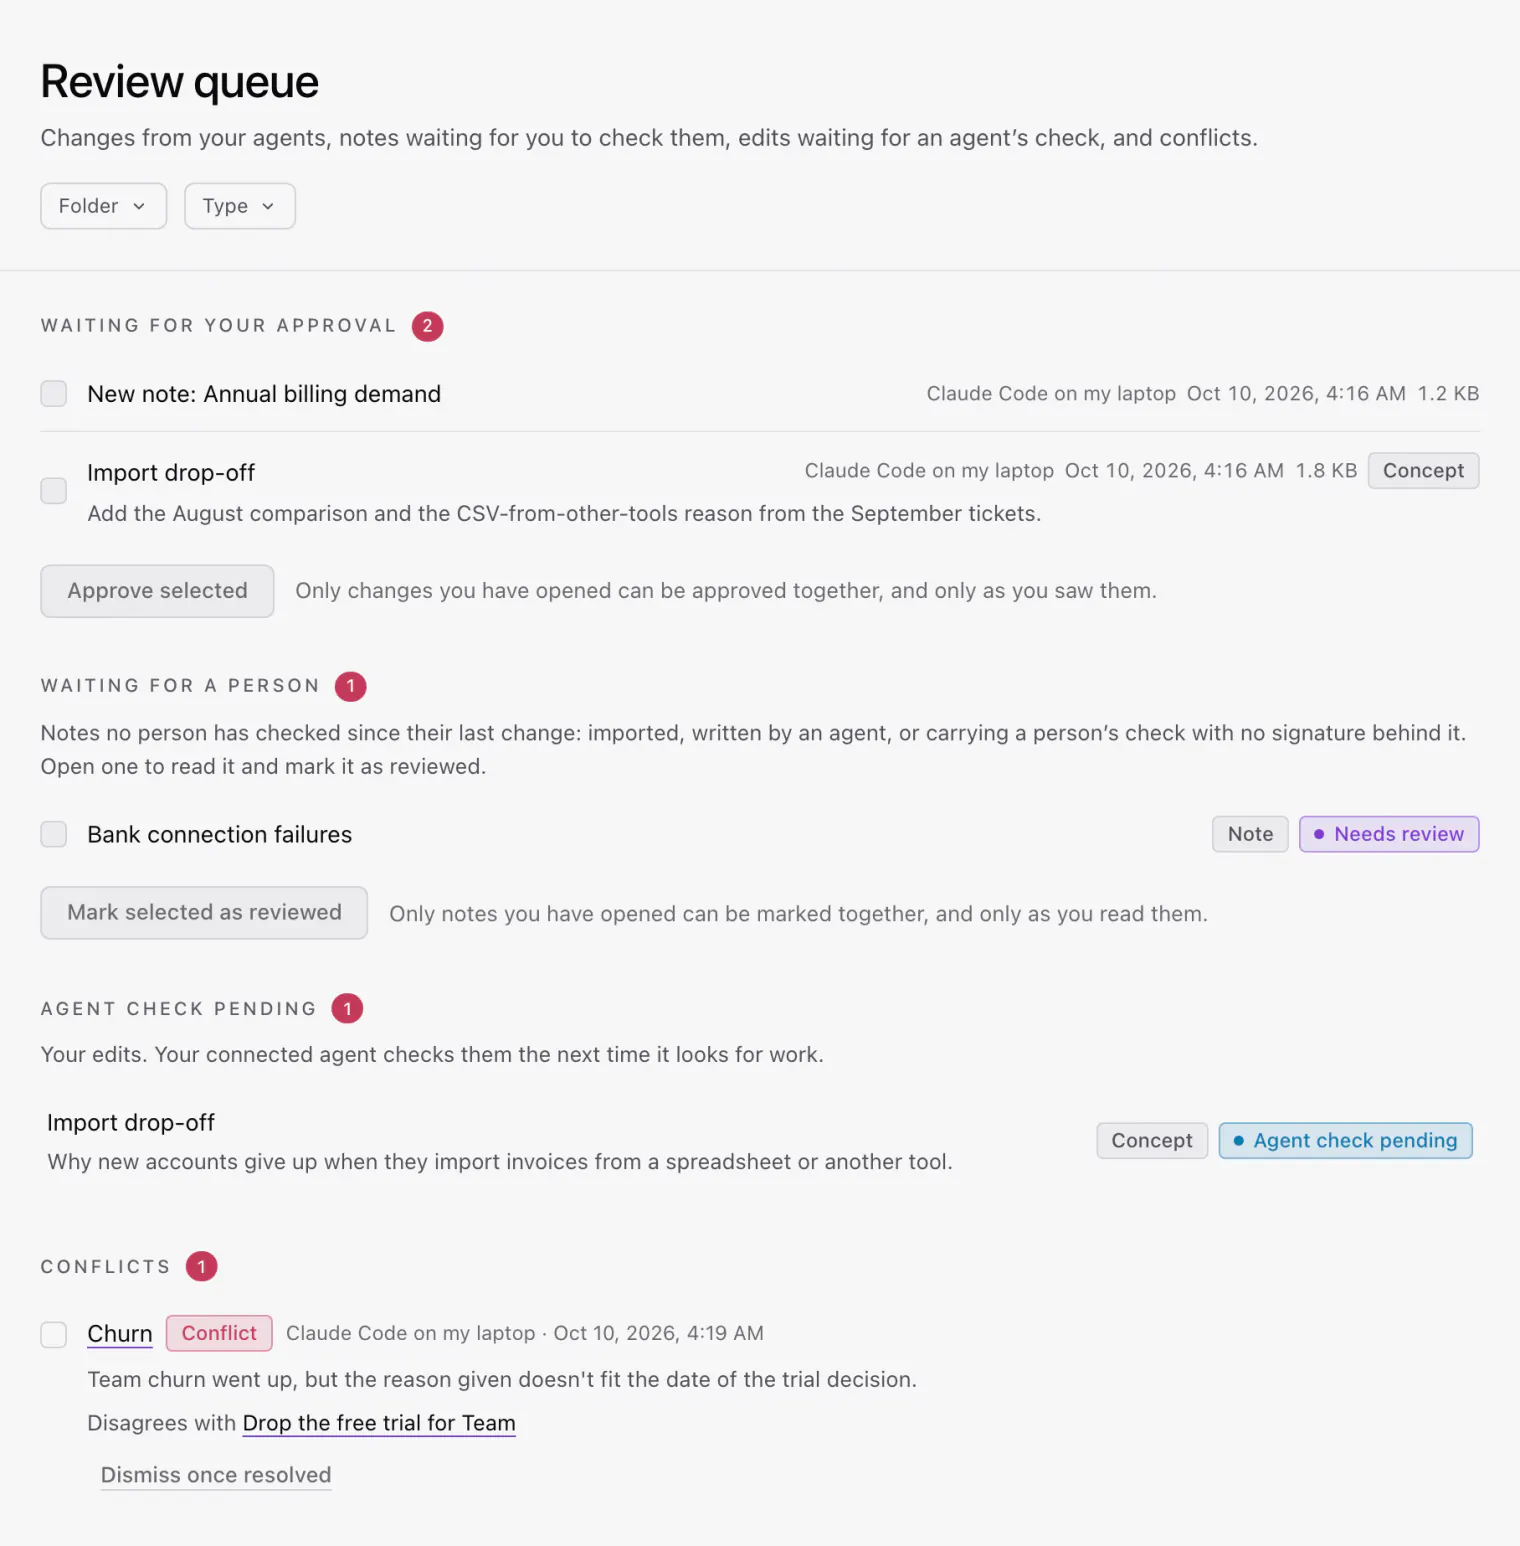
6. Relisez chaque changement avant que quiconque s’y fie
C’est l’étape que la plupart des équipes sautent, et c’est celle qui compte. Les agents devraient ouvrir une pull request (ou laisser les changements non commités) plutôt qu’écrire directement sur la branche principale. Une personne lit le diff, vérifie la source citée et ajoute sa propre entrée verified quand c’est juste. Le guide comment relire les modifications des agents détaille ce qu’il faut regarder.
Cela marche aussi dans l’autre sens. Quand une personne modifie un document à la main, par exemple pour changer un prix, les autres documents qui mentionnent l’ancien prix deviennent faux. Demandez à un agent de comparer chaque document lié à la modification et de proposer des corrections.
Dans Knowtarium
Knowtarium gère les deux sens là où vous activez la relecture (« Ask me first », par espace de travail ou par dossier). Là, le changement d’un agent attend sous forme de diff jusqu’à ce que vous l’approuviez, ce qui vous ajoute à verified. Votre propre modification attend que vous demandiez à un agent de la vérifier (« vérifie les modifications du jour »), et un document que les deux côtés ont vérifié depuis son dernier changement est entièrement vérifié. Partout ailleurs, les changements des agents sont enregistrés aussitôt, signés et annulables.
 (s’ouvre en grand dans un nouvel onglet)
 (s’ouvre en grand dans un nouvel onglet)
7. Programmez la fraîcheur
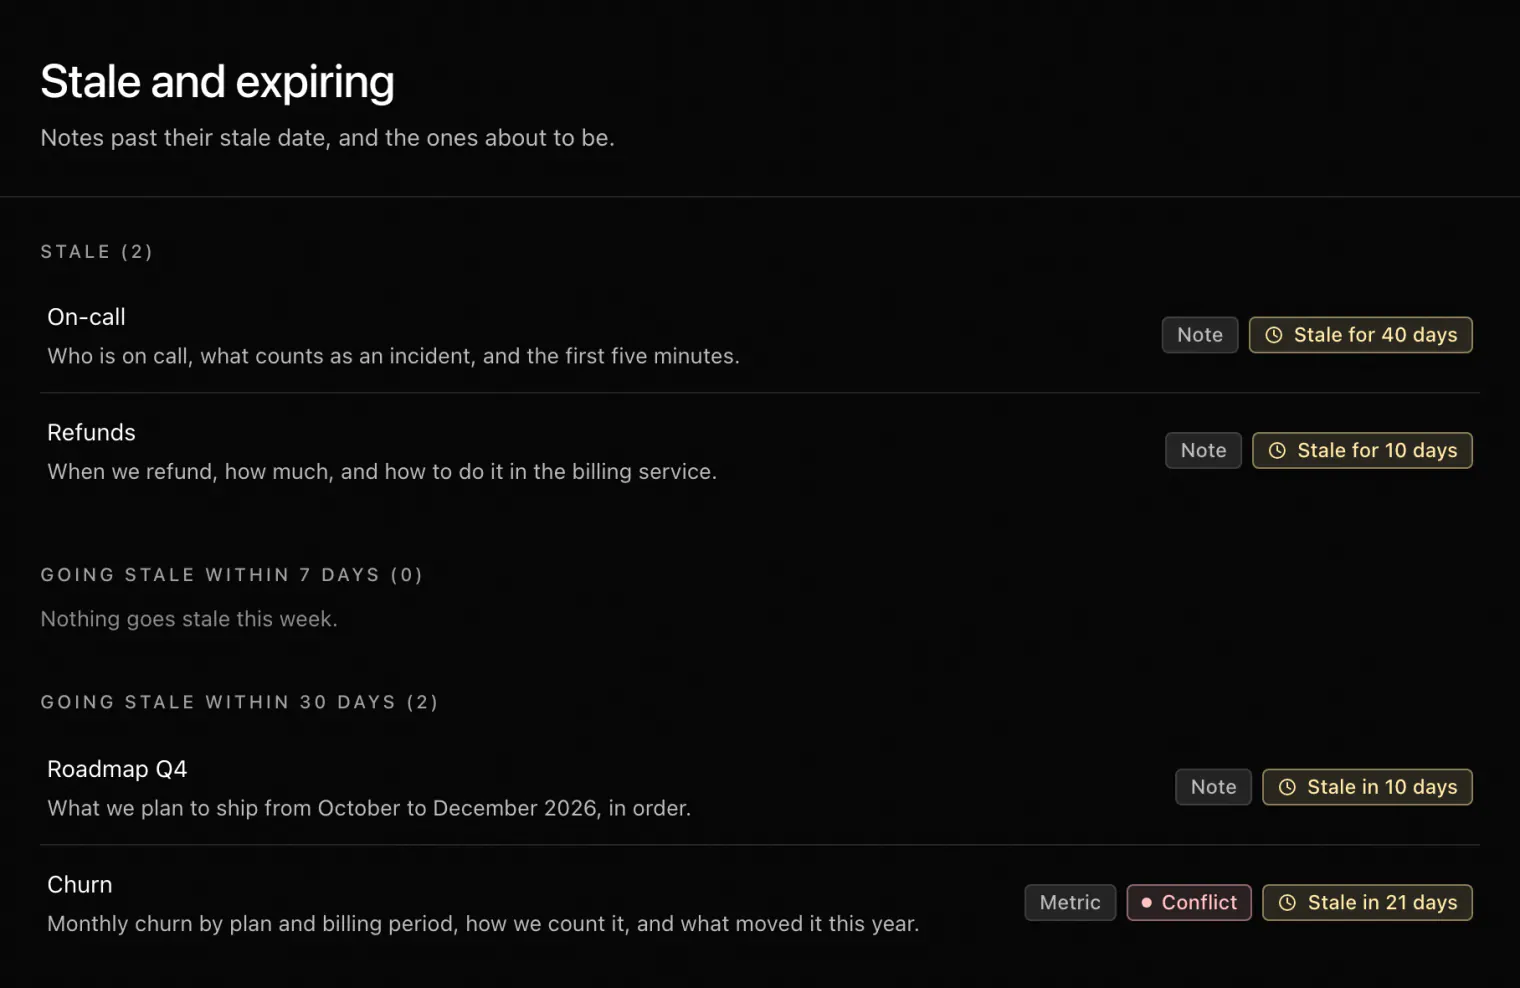
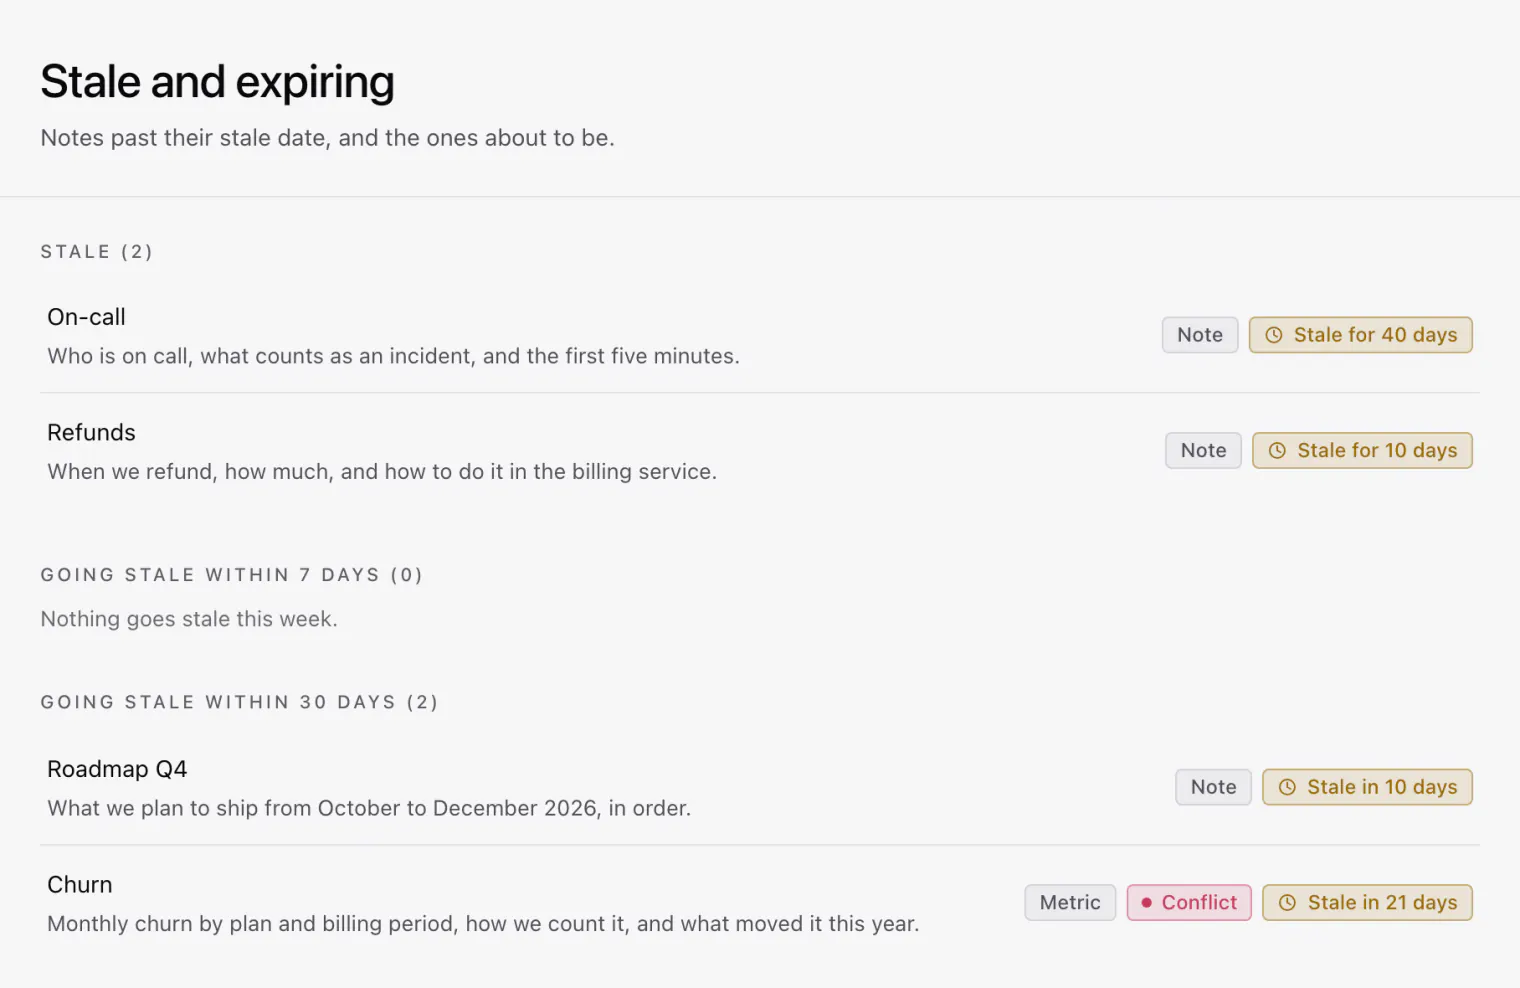
Tout ce qui peut dériver reçoit une date stale_after. Une fois par semaine, demandez à un agent de lister les documents qui ont dépassé leur date ou qui vont bientôt expirer, de les revérifier par rapport à leurs sources et de proposer des mises à jour. Les documents que personne ne revérifie passent en status: deprecated au lieu de rester là à induire en erreur.
Dans Knowtarium
Dans Knowtarium, la page Stale and expiring liste les documents qui ont dépassé stale_after et ceux qui arrivent à échéance, et les agents peuvent demander la même liste, prête à revérifier.
 (s’ouvre en grand dans un nouvel onglet)
 (s’ouvre en grand dans un nouvel onglet)
8. Donnez à chaque agent le même point d’entrée
Les agents de code qui travaillent dans le dépôt lisent directement les fichiers. Pour les applications de chat sans accès aux fichiers, un serveur MCP posé sur le dossier peut leur fournir les documents à la demande. Dans les deux cas, les agents lisent les mêmes fichiers que ceux que les personnes relisent : il n’y a qu’une version de la vérité.
Une règle utile
Les agents peuvent tout écrire, mais ils ne marquent jamais leur propre travail comme vérifié par une personne. Seule une personne ajoute une entrée human: à verified. Cette seule règle garde les niveaux de confiance honnêtes.
Construire un cerveau d’entreprise avec Knowtarium
Voici la même construction avec Knowtarium dans la boucle, en suivant la décision de prix de l’exemple ci-dessus. Knowtarium ne remplace pas votre agent. C’est là que vivent les documents, chiffrés de bout en bout, là que vous voyez ce qu’a fait chaque agent, et là que vous décidez de ce qui compte comme vérifié.
Importez le dossier company-brain dans un espace de travail, connectez vos agents avec et activez la relecture pour les dossiers qui touchent à l’argent, comme company/decisions/.
- Laissez un agent écrire, puis regardez ce qui a changé. Demandez à l’agent de transformer le compte rendu de la réunion sur les prix en document de décision. Comme la relecture est activée pour ce dossier, il attend sous forme de diff, marqué comme non vérifié. Lisez-le, ouvrez le compte rendu cité et approuvez-le : Knowtarium vous ajoute à
verifiedavec l’heure. S’il est faux, rejetez-le avec un commentaire. Dans les dossiers sans relecture, le changement est enregistré aussitôt, signé par l’agent et signalé sur le document, avec Undo à un clic. - Modifiez un fait vous-même, et faites-le vérifier par un agent. Imaginons que la remise annuelle change. Vous modifiez la décision dans Knowtarium, le changement est signé à votre nom et il attend la vérification d’un agent. Demandez à votre agent de « vérifier les modifications du jour » : il lit le diff, suit les liens vers des documents comme
plans-and-limits.md, et corrige ou signale chaque endroit où l’ancien chiffre apparaît encore. Une fois les deux vérifications enregistrées, la décision est entièrement vérifiée. - Surveillez la fraîcheur. La décision expire le 31 mars 2027. La page Stale and expiring la liste à l’approche de la date, puis comme périmée une fois la date passée, jusqu’à ce que quelqu’un la mette à jour. Une mise à jour est un nouveau changement : elle a donc droit à sa propre relecture.
- Emportez-le avec vous. Exportez l’espace de travail ou un dossier en markdown simple quand vous voulez. Les entrées
verifiedvoyagent avec les fichiers : quiconque les lit voit qui a vérifié quoi, dans n’importe quel éditeur.
Ce que les agents ne peuvent pas faire
Dans Knowtarium, les agents peuvent lire, écrire, vérifier vos modifications et mettre à jour les documents périmés, dans l’espace de travail et les dossiers auxquels vous les avez connectés. Ils ne suppriment ou ne déplacent des documents que si vous leur en avez donné la permission, ils ne peuvent rien marquer comme vérifié par une personne, et dans les dossiers où la relecture est activée, ils ne peuvent pas passer outre votre relecture. Chaque changement qu’ils font est signé : il peut donc toujours être retracé et annulé.
Faire vivre un cerveau d’entreprise en équipe
Un cerveau d’entreprise en markdown dans git se partage comme le code : par le dépôt. Chacun le clone, agents et personnes modifient les fichiers, et les changements arrivent par des commits et des pull requests. Git fournit l’historique, les branches et les conflits de fusion ; votre hébergeur git fournit le contrôle d’accès.
C’est aussi le moment d’être précis sur ce que Knowtarium fait et ne fait pas aujourd’hui.
- Le partage en équipe n’existe pas encore. Un compte Knowtarium et ses espaces de travail appartiennent à une seule personne : il n’y a ni espaces partagés, ni permissions par membre, ni édition à plusieurs en temps réel. Les espaces partagés sont prévus, mais pas pour la première version.
- Ce que vous pouvez partager, ce sont les fichiers. Quand vous approuvez un changement dans Knowtarium, votre nom et l’heure s’ajoutent à la liste
verifieddu document. Exportez l’espace de travail en markdown simple et mettez-le dans un dépôt : tous ceux qui le lisent voient la relecture, quel que soit l’outil avec lequel ils ouvrent le fichier. C’est une copie, pas un lien en direct. - Une personne, plusieurs agents. Vous pouvez connecter plusieurs agents (Claude Code, Codex, Cursor, Claude Desktop), chacun à un espace de travail ou seulement à certains de ses dossiers, en lecture seule ou en lecture-écriture. Chaque changement montre quel agent l’a fait, et en révoquer un le coupe aussitôt.
- Tout le monde n’en a pas besoin. Les collègues qui ne relisent jamais peuvent lire les fichiers exportés dans leur éditeur, les parcourir sur votre hébergeur git ou les faire lire par leurs agents.
Si vous avez besoin aujourd’hui d’un espace partagé, de permissions par document, d’une console d’administration ou d’édition à plusieurs en direct, Knowtarium n’est pas encore fait pour ça. Aujourd’hui, il s’adresse à la personne qui tient le cerveau et vérifie ce que les agents écrivent.
Les erreurs courantes en construisant un cerveau d’entreprise
- Tout ingérer. Déverser chaque canal et chaque boîte de réception dans le cerveau enterre les réponses arrêtées sous la discussion. Capturez les décisions et les définitions, et liez la matière brute comme source.
- Pas de provenance. Dès que vous ne savez plus quels documents un agent a écrits sans que personne ne les vérifie, vous devez vous méfier de tous.
- Des agents qui approuvent des agents. Un deuxième agent qui confirme le premier, c’est utile, mais ce n’est pas la relecture d’une personne. Gardez les deux séparés.
- Pas de date d’expiration. Les prix, les responsables, les limites et les organigrammes se périment en quelques mois. Sans
stale_after, les documents périmés ressemblent exactement aux documents à jour. - Citer des choses qui disparaissent. Un lien vers un message de chat ou une réunion que personne n’a enregistrée n’est pas une source. Enregistrez la source dans le dépôt (en compte rendu ou en export) et citez le fichier.
- Pas de responsable. Quelqu’un doit regarder ce que les agents ont changé. Si la relecture est l’affaire de tous, elle devient l’affaire de personne.
Questions
Qu’est-ce qu’un cerveau d’entreprise (company brain) ?
Un cerveau d’entreprise est la mémoire écrite et partagée du fonctionnement d’une entreprise (ses décisions, ses définitions, ses processus et ses clients), tenue à jour et structurée pour que les personnes comme les agents IA puissent la trouver, la lire et s’y fier.
En quoi un cerveau d’entreprise diffère-t-il d’un wiki ?
Un wiki est entretenu par des personnes et a tendance à se périmer. Un cerveau d’entreprise est entretenu surtout par des agents, qui captent la nouvelle connaissance et mettent à jour les documents existants, pendant que des personnes relisent les changements. Il note aussi qui a écrit chaque document, qui l’a vérifié, d’où viennent les affirmations et quand il expire.
Faut-il une base de données vectorielle pour construire un cerveau d’entreprise ?
Non. Vous pouvez tenir un cerveau d’entreprise sous forme de fichiers markdown dans un dépôt git, que les agents de code comme Claude Code, Codex et Cursor lisent directement. Une base vectorielle aide pour les collections énormes, mais elle est difficile à lire ou à relire pour une personne.
Comment empêcher les agents IA de remplir un cerveau d’entreprise d’informations fausses ?
Notez qui a écrit chaque document, exigez une source pour chaque affirmation, donnez une date d’expiration aux faits qui changent vite, et faites relire chaque changement d’agent par une personne avant de s’y fier. Ne laissez jamais un agent marquer son propre travail comme vérifié par une personne.
Une équipe peut-elle utiliser Knowtarium comme cerveau d’entreprise partagé ?
Pas encore. Aujourd’hui, un compte Knowtarium et ses espaces de travail appartiennent à une seule personne : il n’y a ni espaces partagés, ni permissions par membre, ni collaboration en temps réel. Vous pouvez exporter un espace de travail en fichiers markdown OKF bruts quand vous voulez et les partager, par exemple dans un dépôt git.