Erklärung
Company Brain: was es ist und wie du eins für KI-Agenten aufbaust
Ein Company Brain ist das gemeinsame Gedächtnis darüber, wie deine Firma arbeitet, aktuell gehalten und so strukturiert, dass Menschen und KI-Agenten es lesen und ihm vertrauen können. Hier steht, was es können muss, wie sich die üblichen Ansätze unterscheiden und wie du eins aus Markdown-Dokumenten aufbaust, die deine Agenten pflegen, und wie du mit Knowtarium den Überblick behältst, was sie schreiben.
Von Fadel Kaadan · Aktualisiert am
Was ist ein Company Brain?
Ein Company Brain (auf Deutsch etwa: Firmengedächtnis) ist das gemeinsame, schriftliche Gedächtnis darüber, wie eine Firma arbeitet: ihre Entscheidungen, Definitionen, Abläufe, Kunden und Lektionen. Es wird aktuell gehalten und so strukturiert, dass Menschen und KI-Agenten es finden, lesen und ihm vertrauen können.
Es beantwortet Fragen wie „Was zählt bei uns als aktiver Kunde?“, „Warum haben wir den Free-Plan abgeschafft?“ und „Wer ist für den Billing-Export zuständig?“. Diese Antworten stecken meist im Kopf von jemandem, in einem Chat-Thread vom letzten Frühjahr und in drei Wiki-Seiten, die sich widersprechen. Ein Company Brain legt eine aktuelle Antwort an einen Ort und hält fest, woher sie kommt.
Ein paar Dinge, die ein Company Brain nicht ist:
- Kein Modell. Das Brain ist das Wissen. Der Chatbot oder Agent, der daraus Fragen beantwortet, ist nur eine Oberfläche darüber.
- Kein Haufen von allem. Wenn du jede E-Mail und jede Chatnachricht indexierst, bekommst du eine Suche, kein Gedächtnis. Ein Brain enthält die verdichtete Fassung: die Entscheidung, nicht die 200 Nachrichten, die dahin geführt haben.
- Keine App für persönliche Notizen. Ein Second Brain dient dem Denken einer einzelnen Person. Ein Company Brain wird geteilt, deshalb zählen Genauigkeit, Zuständigkeit und Prüfung mehr als schnelles Festhalten.
In Knowtarium
Knowtarium ist eine Ende-zu-Ende-verschlüsselte Wissensdatenbank, die Menschen und KI-Agenten gemeinsam schreiben, gebaut für genau diese Art von Brain: Markdown-Dokumente in Workspaces und Ordnern, und jedes zeigt, wer es geschrieben hat (und in Ordnern mit Review, wer es geprüft hat). Der Einstieg ist kostenlos. Ein Workspace gehört bisher einer einzelnen Person; Teilen mit einem Team gibt es noch nicht.
Warum der Begriff durchgestartet ist
Firmen wollen eine einzige verlässliche Quelle, seit es Wikis gibt. Neu ist, wer sie liest. KI-Agenten schreiben inzwischen Code, beantworten Kundenanfragen, entwerfen Berichte und machen Analysen, und jeder von ihnen braucht dafür Kontext über die Firma.
Ein Mensch kommt mit fehlendem Kontext zurecht: Er fragt eine Kollegin, erinnert sich ans letzte Quartal, merkt, dass eine Zahl komisch aussieht. Ein Agent tut nichts davon. Er kennt, was in seinem Kontextfenster steht, sonst nichts, und die meisten Agenten fangen jede Sitzung bei null an. Die Dokumentation von Claude Code sagt es klar: Jede Sitzung beginnt mit einem frischen Kontextfenster, und was bleibt, ist das, was in Dateien steht, etwa in CLAUDE.md oder AGENTS.md. Steht der Kontext nirgends, rät der Agent.
Der zweite Grund: Wikis verrotten. Andrej Karpathys Notiz LLM Wiki, veröffentlicht im April 2026, bringt das Problem in einem Satz auf den Punkt:
„Menschen geben Wikis auf, weil der Pflegeaufwand schneller wächst als ihr Nutzen.“
Sein Vorschlag: Das Modell soll die Buchhaltung machen. Ein Agent liest Rohquellen, schreibt und aktualisiert verlinkte Markdown-Seiten und prüft sie regelmäßig auf Widersprüche, veraltete Aussagen und verwaiste Seiten. Menschen kuratieren und stellen Fragen. Diese Idee (Agenten pflegen das Wissen, statt es nur zu durchsuchen) unterscheidet ein Company Brain von dem Wiki, das du schon hast. (Unsere Anleitung zum LLM-Wiki erklärt das Muster.)
Von dort aus hat sich der Begriff verbreitet. Heute steht er für gehostete Wikis mit KI-Suche genauso wie für Open-Source-Projekte, die das Gedächtnis eines Agenten als Markdown-Dateien in Git ablegen. Am stärksten unterscheiden sie sich bei der Frage, die Karpathys Notiz den Menschen überlässt: Wer prüft, was die Agenten geschrieben haben?
Was ein Company Brain können muss
Egal, welches Tool du nutzt: Ein Company Brain hat vier Aufgaben. Die ersten drei erledigen die meisten Setups ganz ordentlich. Bei der vierten unterscheiden sie sich am stärksten, und sie entscheidet, ob sich jemand auf die Antworten verlässt.
1. Festhalten, was zählt
Wissen muss hineinkommen, ohne dass jemand es von Hand kopiert: Meeting-Notizen, Entscheidungen, Muster aus dem Support, Berichte zu Vorfällen, Änderungen an Preisen oder Abläufen. In der Praxis heißt das: Agenten lesen das Rohmaterial und schreiben oder aktualisieren das passende Dokument.
2. Aktuell bleiben
Ein Brain, das im März stimmte, ist im September gefährlich, denn es klingt genauso sicher. Jeder Fakt, der sich ändern kann, braucht ein Datum, nach dem ihn jemand erneut prüft, und einen Weg, alles zu finden, was an diesem Fakt hängt, wenn er sich ändert.
3. Für Menschen und Agenten abfragbar sein
Menschen müssen darin stöbern und suchen können. Agenten müssen es lesen können, ohne dass jedes Tool eine eigene Integration braucht: reiner Text, vorhersehbare Struktur, kurze Beschreibungen, die sie überfliegen können, bevor sie ein ganzes Dokument öffnen.
4. Vertrauenswürdig sein
Wenn Agenten einen großen Teil der Inhalte schreiben, muss jedes Dokument auf einen Blick vier Fragen beantworten:
- Wer hat es geschrieben? Ein Mensch oder ein Agent (und welcher)?
- Wer hat es geprüft? Hat ein Mensch es durchgesehen, nur ein anderer Agent oder niemand?
- Woher stammt es? Welche Quelle stützt welche Aussage?
- Stimmt es noch? Wann wurde es zuletzt bestätigt, und wann läuft es ab?
Ohne diese Antworten füllt sich das Brain langsam mit plausiblem Text, den niemand geprüft hat, und die Leute trauen nichts mehr davon. Eine KI-Antwort, die sich auf ein ungeprüftes, ein Jahr altes Dokument stützt, ist schlimmer als gar keine, weil sie maßgeblich wirkt.
In Knowtarium
Abgesehen von einem Web-Clipper, der Links speichert, überlässt Knowtarium das Festhalten deinen Agenten und legt sein Gewicht auf die vierte Aufgabe. Wer ein Dokument geschrieben hat, woher es stammt und wann es abläuft, steht oben auf der Seite, und Dokumente nach ihrem Datum stehen auf der Seite Stale and expiring. In Ordnern mit Review zeigt die Seite auch, wer es geprüft hat, und der Graph kann Dokumente nach Vertrauensstufe einfärben (unverified, machine-confirmed oder human-reviewed). Menschen durchsuchen in der App den Volltext, und Agenten lesen dieselben Dokumente über MCP.
Drei Wege, ein Company Brain aufzubauen
Gehostetes Wiki plus KI-Suche
Der häufigste Weg: Du behältst (oder holst dir) eine gehostete Wissensdatenbank und setzt eine KI-Schicht darauf, die sie und deine anderen Tools durchsucht. Die Produkte in dieser Kategorie unterscheiden sich in ihrer Reichweite und darin, wie viel ihre KI ändern darf:
- Enterprise Search. Verbindet sich mit Hunderten Arbeits-Apps (Chat, geteilte Laufwerke, Issue-Tracker, CRMs) und beantwortet Fragen über alle hinweg, wobei jede Person nur sieht, was sie sehen darf.
- Wikis mit eingebautem Assistenten. Beantworten Fragen aus dem Wiki und einigen verbundenen Apps, und ihre Agenten dürfen Seiten anlegen und bearbeiten.
- Wikis, die sich selbst pflegen. Beobachten deine anderen Tools, entwerfen ein Update, wenn eine Seite veraltet, und geben es einer Person zur Freigabe.
Stärken: Berechtigungen, der Einstieg für nichttechnische Teams, die Suche über alles auf einmal, null Einrichtung für die meisten Leute. Schwächen: Das Wissen liegt in der Datenbank eines Anbieters, und Coding-Agenten, die in einem Repo arbeiten, erreichen es meist über eine API oder einen MCP-Server, statt es direkt zu lesen. Und eine Suche über Rohquellen findet den widersprüchlichen Chat-Thread genauso leicht wie die geklärte Antwort.
Vektordatenbank und RAG
Engineering-Teams bauen oft selbst: Dokumente in Abschnitte zerlegen, Embeddings berechnen, die Vektoren speichern und bei einer Frage die ähnlichsten Abschnitte abrufen (Retrieval-Augmented Generation). Das ist flexibel und skaliert auf riesige Bestände.
Stärken: große Sammlungen, die sich schnell ändern; eigene Pipelines. Schwächen: Eine Vektordatenbank kann niemand lesen. Widersprüche stehen nebeneinander, die Suche liefert den Abschnitt mit dem höchsten Score, und es gibt keinen natürlichen Ort, um festzuhalten, wer einen Fakt geprüft hat oder wann er abläuft. Am Ende baust du doch eine Prüfschicht obendrauf.
Markdown-Dateien in Git, direkt von Agenten gelesen
Der Ansatz, auf den Coding-Teams von selbst gekommen sind: Das Wissen ist ein Ordner mit Markdown-Dateien in einem Repository. Claude Code, Codex, Cursor und andere Agenten lesen und bearbeiten die Dateien mit denselben Tools wie Code. Eine Datei mit Konventionen (AGENTS.md, ein offenes Format, das laut agents.md von Codex, Cursor und vielen anderen Coding-Agenten unterstützt wird, oder CLAUDE.md bei Claude Code) sagt ihnen, wie der Ordner aufgebaut ist. Genau so sieht Karpathys LLM-Wiki aus.
Stärken: Agenten können es ohne Integration lesen und pflegen, jede Änderung ist ein Diff, den du prüfen kannst, Git liefert Verlauf und Blame gratis mit, und nichts hängt an einem Anbieter. Schwächen: keine Berechtigungen über das hinaus, was das Repository erlaubt, kein schöner Editor für nichttechnische Kollegen, und Git allein sagt dir nicht, welche Dokumente ein Mensch geprüft hat.
| Gehostetes Wiki + KI-Suche | Vektordatenbank / RAG | Markdown in Git | |
|---|---|---|---|
| Wo das Wissen liegt | In der Cloud des Anbieters | In deiner Datenbank, als Vektoren | In einfachen Dateien, die dir gehören |
| Agenten lesen es über | API, MCP oder eingebauten Assistenten | Deinen Retrieval-Code | Das Dateisystem |
| Agenten schreiben hinein | Je nach Produkt | Über deine Ingestion-Pipeline | Ja, wie beim Code-Bearbeiten |
| Prüfung von Änderungen | Je nach Produkt | Selbst bauen | Diffs, Pull Requests |
| Berechtigungen | Pro Person, pro Dokument | Selbst bauen | Pro Repository |
| Am besten für | Große oder nichttechnische Organisationen | Riesige Bestände, eigene Produkte | Teams, deren Arbeit schon über Agenten und Git läuft |
Keiner davon ist falsch. Wenn du Hunderte Mitarbeitende hast, strenge Zugriffsregeln und wenige Leute, die ein Terminal öffnen, fährst du mit einem gehosteten Wiki besser. Der Rest dieser Seite dreht sich um den dritten Ansatz, weil dort die Agenten die Pflege übernehmen. Knowtarium baut darauf auf: dieselben Markdown-Dokumente und dasselbe Frontmatter, in einem Ende-zu-Ende-verschlüsselten Workspace, den deine Agenten über MCP erreichen.
So baust du ein Company Brain aus Markdown-Dateien, die deine Agenten pflegen
Damit fängst du an einem Nachmittag an, mit einem Git-Repository und dem Coding-Agenten, den du schon nutzt. Die Schritte unten folgen dem Open Knowledge Format (OKF), einer offenen Spezifikation von Google Cloud (v0.2 auf GitHub) für Markdown-Wissen, das Agenten schreiben. Das Format hängt von keinem Tool ab, und solange nur ein oder zwei Leute den Ordner anfassen, reichen Git-Diffs und ein aufmerksamer Blick oft aus. Bei den meisten Schritten steht, was Knowtarium ergänzt.
1. Fang mit einem Bereich an, der wehtut
Versuch nicht, gleich die ganze Firma zu erfassen. Nimm die Fragen, die am häufigsten gestellt oder am häufigsten falsch beantwortet werden: Preise und Plan-Limits, Definitionen von Kennzahlen, den Release-Prozess, Runbooks für den Bereitschaftsdienst. Ein Brain, das bei zehn Dingen richtig liegt, schlägt eines, das bei tausend ungefähr richtig liegt.
2. Leg das Repository und eine Ordnerstruktur an
Ein Konzept pro Datei, gruppiert in Ordnern, die für dein Team Sinn ergeben:
company-brain/AGENTS.md # die Regeln, die Agenten in diesem Ordner befolgenindex.md # was hier liegt, eine Zeile pro Dokumentlog.md # was sich geändert hat, Neuestes zuerstcompany/glossary.md # was wir unter „aktiver Kunde“, „Churn“, „MRR“ verstehendecisions/2026-08-pricing.md # eine Entscheidung pro Datei, mit Begründungproduct/plans-and-limits.mdrelease-process.mdmeetings/2026-08-14-pricing-review.mdcustomers/segments.mdaccounts/northwind.mdrunbooks/refunds.mdon-call.md
index.md und log.md sind in OKF reservierte Namen: Die erste listet, was ein Ordner enthält, die zweite hält fest, was sich geändert hat. Agenten lesen zuerst den Index und öffnen dann nur die Dokumente, die sie brauchen.
In Knowtarium
Importier diesen Ordner in einen Knowtarium-Workspace, und er ist so, wie er ist, ein OKF-Bundle: Die Ordner kommen mit, und Dokumente mit fehlenden Feldern lassen sich trotzdem öffnen. Graph, Suche und Eigenschaftsansicht arbeiten mit denselben Dokumenten, die deine Agenten bearbeiten.
3. Schreib die Regeln für deine Agenten auf
Leg die Konventionen in AGENTS.md ab (und verweise in CLAUDE.md darauf, wenn du Claude Code nutzt). Halte sie kurz und konkret. Unsere Anleitung zu AGENTS.md für Wissensdatenbanken hat eine ausführlichere Fassung.
# Regeln für diese Wissensdatenbank- Ein Konzept pro Datei. Erst suchen, dann anlegen; lieber die vorhandene Datei aktualisieren.- Jede Datei beginnt mit Frontmatter: type, title, description.- Wenn du eine Datei schreibst oder änderst, setze generated.by auf deinen Agentennamen und deine Version.- Trag dich oder jemand anderen nie in verified ein. Das machen nur Prüfer.- Jede Tatsachenbehauptung nennt eine Quelle als Fußnote: [^source-id].- Gib Fakten, die sich schnell ändern (Preise, Zuständige, Limits), ein stale_after-Datum.- Verlinke verwandte Dokumente mit Markdown-Links ab dem Bundle-Root: [Churn](/metrics/churn.md).- Schreib für jede Änderung eine Zeile in log.md: Datum, Datei, was und warum.
In Knowtarium
Verbinde Claude Code, Codex oder Cursor mit , und Knowtarium gibt dem Agenten mit seinen Tools die wichtigsten Konventionen mit: zuerst die eigene index.md des Workspace lesen, wo es eine gibt, Beschreibungen vor ganzen Dokumenten lesen und nie etwas als von einem Menschen geprüft markieren. Jede Änderung, die er macht, ist mit seinem eigenen Schlüssel signiert. Schreib deine AGENTS.md direkt in den Workspace, für den ganzen Workspace oder einen Ordner, und jeder verbundene Agent befolgt sie bei jedem Dokument, das er dort schreibt.
4. Halte in jedem Dokument die Herkunft fest
Das Frontmatter macht das Brain vertrauenswürdig. OKF definiert Felder für genau die vier Fragen von oben: generated (wer es wann geschrieben hat), verified (wer es geprüft hat), sources (woher die Aussagen stammen) und stale_after (wann es wieder geprüft werden muss).
---type: Decisiontitle: Jahrespläne bekommen zwei Monate gratisdescription: Warum der Jahrespreis das Zehnfache des Monatspreises ist und wann wir das neu bewerten.status: stablegenerated: { by: claude-code/2.1, at: 2026-09-20T09:12:00Z }verified:- { by: human:sara, at: 2026-09-21T14:30:00Z }stale_after: 2027-03-31T00:00:00Zsources:- id: pricing-reviewresource: /meetings/2026-08-14-pricing-review.mdauthor: human:sara---Jahrespläne kosten das Zehnfache des Monatspreises.[^pricing-review]Wir bewerten das Ende Q1 neu, sobald die Churn-Zahlen da sind.
Akteure werden in einer festen Form genannt: ein Agent mit seiner Version (claude-code/2.1), ein Mensch (human:sara) oder ein Prozess (process:billing-sync). So kann jeder, der das Dokument liest, seine Vertrauensstufe aus der verified-Liste ablesen, statt einem Label zu glauben. Wie das mit den Fußnoten geht, steht in So bringst du Agenten dazu, Quellen zu nennen.
In Knowtarium
Knowtarium zeigt dieses Frontmatter oben im Dokument als Eigenschaften statt als rohes YAML. Deine eigenen Schlüssel, etwa ein Feld owner, bleiben genau so, wie du sie geschrieben hast.
5. Füll es mit dem, was du schon hast
Gib einem Agenten deinen bestehenden Wiki-Export, Meeting-Notizen oder einen Ordner mit Entscheidungen und bitte ihn, ein Dokument pro Konzept zu schreiben und für jede Aussage die Quelldatei zu nennen. Rechne im ersten Durchgang mit Dubletten und Widersprüchen. Das ist nützlich: Sie zeigen dir, wo deine bisherige Dokumentation sich selbst widerspricht.
In Knowtarium
Jedes Dokument, das der Agent beim Befüllen schreibt, ist mit seinem Namen signiert und hat keinen Eintrag in verified, bis jemand es prüft. So gehen befüllte Dokumente nie als geprüfte durch, und jedes lässt sich rückgängig machen. Liegen deine Notizen in einem Obsidian-Vault, importier ihn in einen Workspace, und er wird in OKF umgewandelt, ohne dass sich an deinem Text etwas ändert.
6. Prüf jede Änderung, bevor sich jemand darauf verlässt
Diesen Schritt lassen die meisten Teams aus, und genau er zählt. Agenten sollten einen Pull Request öffnen (oder Änderungen uncommittet lassen), statt direkt in den Main-Branch zu schreiben. Ein Mensch liest den Diff, prüft die genannte Quelle und fügt seinen eigenen verified-Eintrag hinzu, wenn alles stimmt. Worauf du dabei achtest, steht in So prüfst du Agenten-Änderungen.
Das funktioniert auch andersherum. Wenn ein Mensch ein Dokument von Hand ändert, etwa einen Preis, sind andere Dokumente mit dem alten Preis jetzt falsch. Bitte einen Agenten, jedes verbundene Dokument mit der Änderung abzugleichen und Korrekturen vorzuschlagen.
In Knowtarium
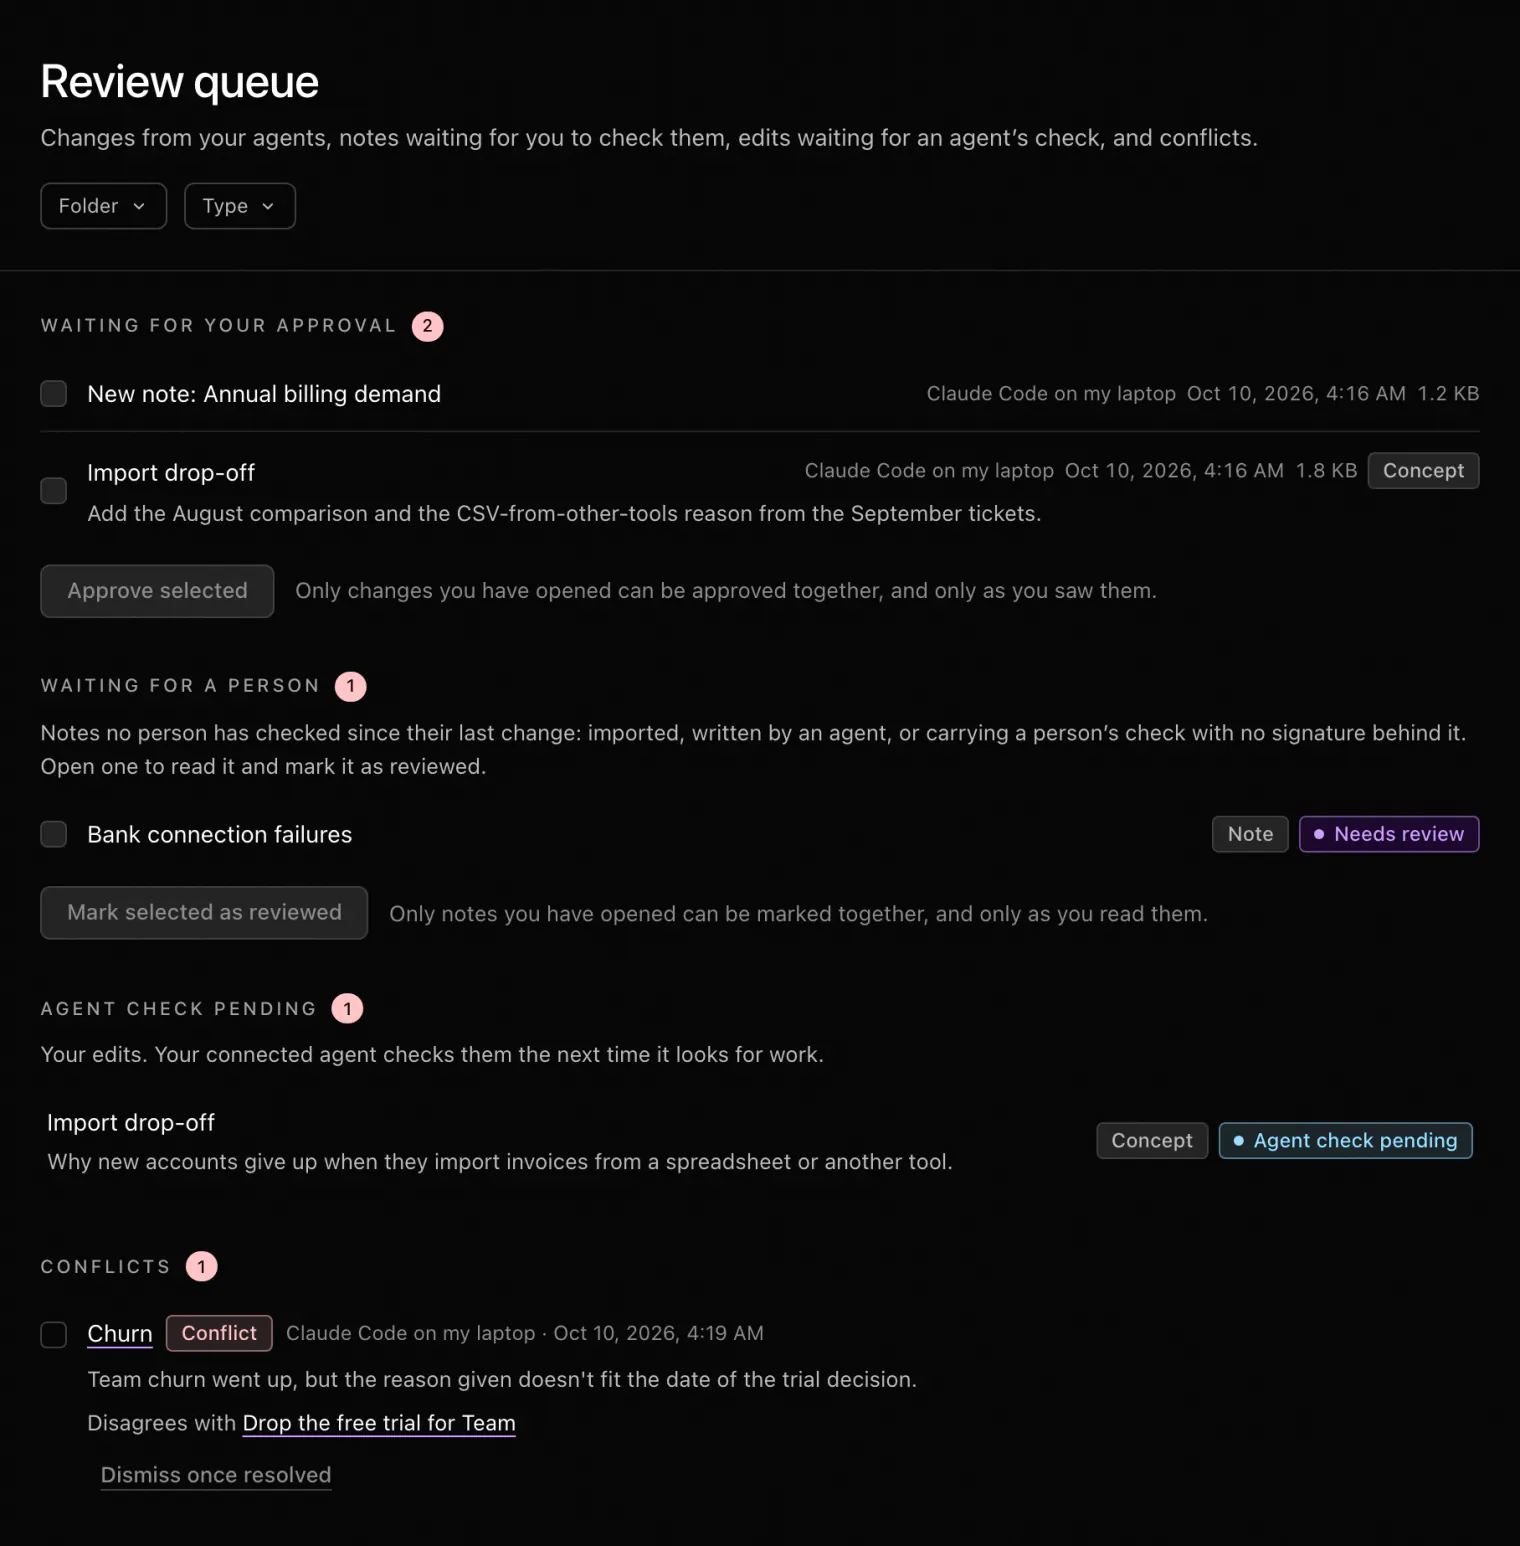
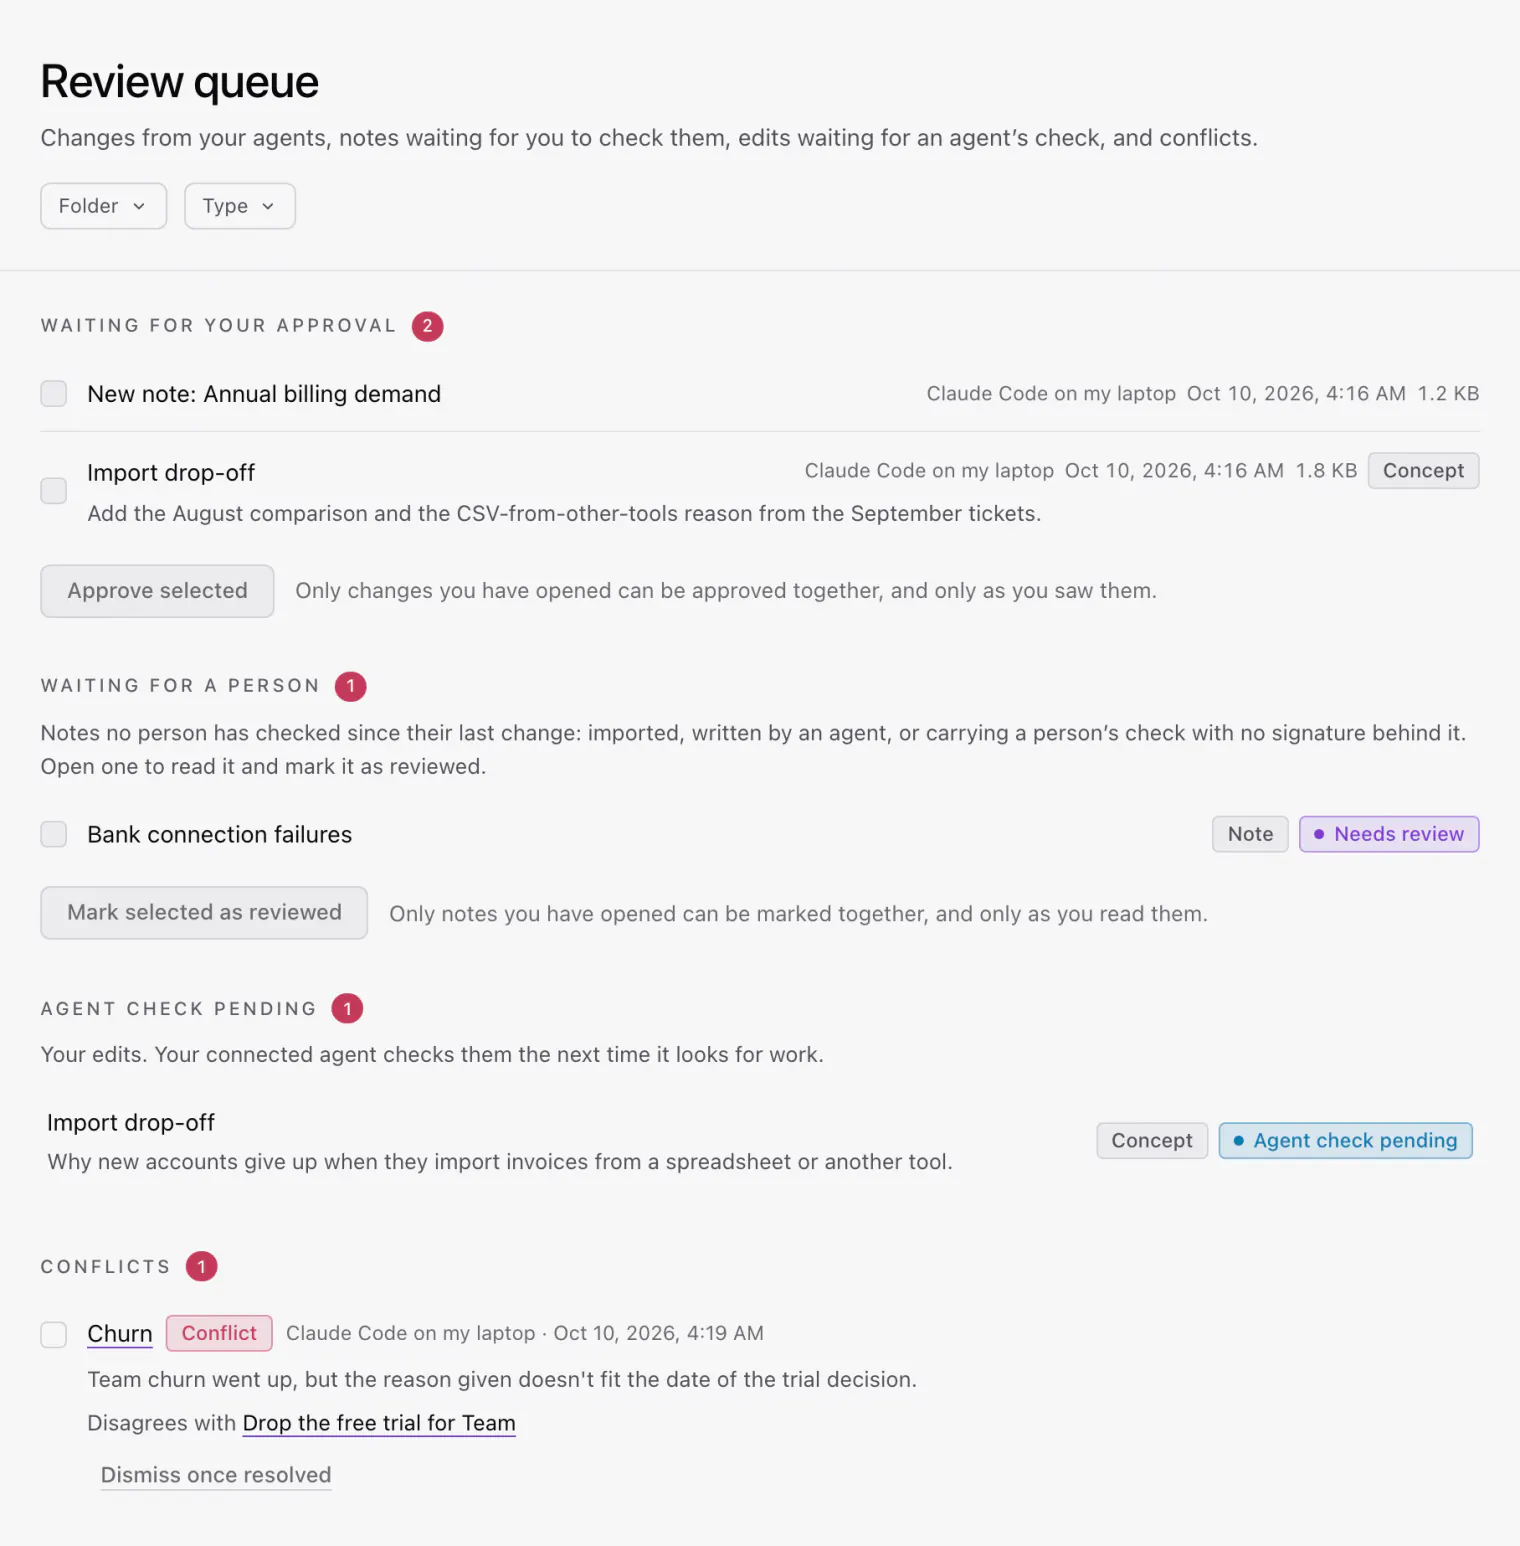
Knowtarium macht beides, wo du Review einschaltest („Ask me first“, pro Workspace oder Ordner). Dort wartet die Änderung eines Agenten als Diff, bis du sie freigibst, und die Freigabe trägt dich in verified ein. Deine eigene Änderung wartet, bis du einen Agenten bittest, sie zu prüfen („prüf die Änderungen von heute“), und ein Dokument, das seit seiner letzten Änderung von beiden Seiten geprüft wurde, ist vollständig verifiziert. Überall sonst werden Änderungen von Agenten sofort gespeichert, signiert und lassen sich rückgängig machen.
 (öffnet in voller Größe in einem neuen Tab)
 (öffnet in voller Größe in einem neuen Tab)
7. Gib der Aktualität einen festen Rhythmus
Alles, was veralten kann, bekommt ein stale_after-Datum. Lass einmal pro Woche einen Agenten die Dokumente auflisten, deren Datum überschritten ist oder bald abläuft, sie mit ihren Quellen abgleichen und Updates vorschlagen. Dokumente, die niemand neu prüft, werden als status: deprecated markiert, statt weiter in die Irre zu führen.
In Knowtarium
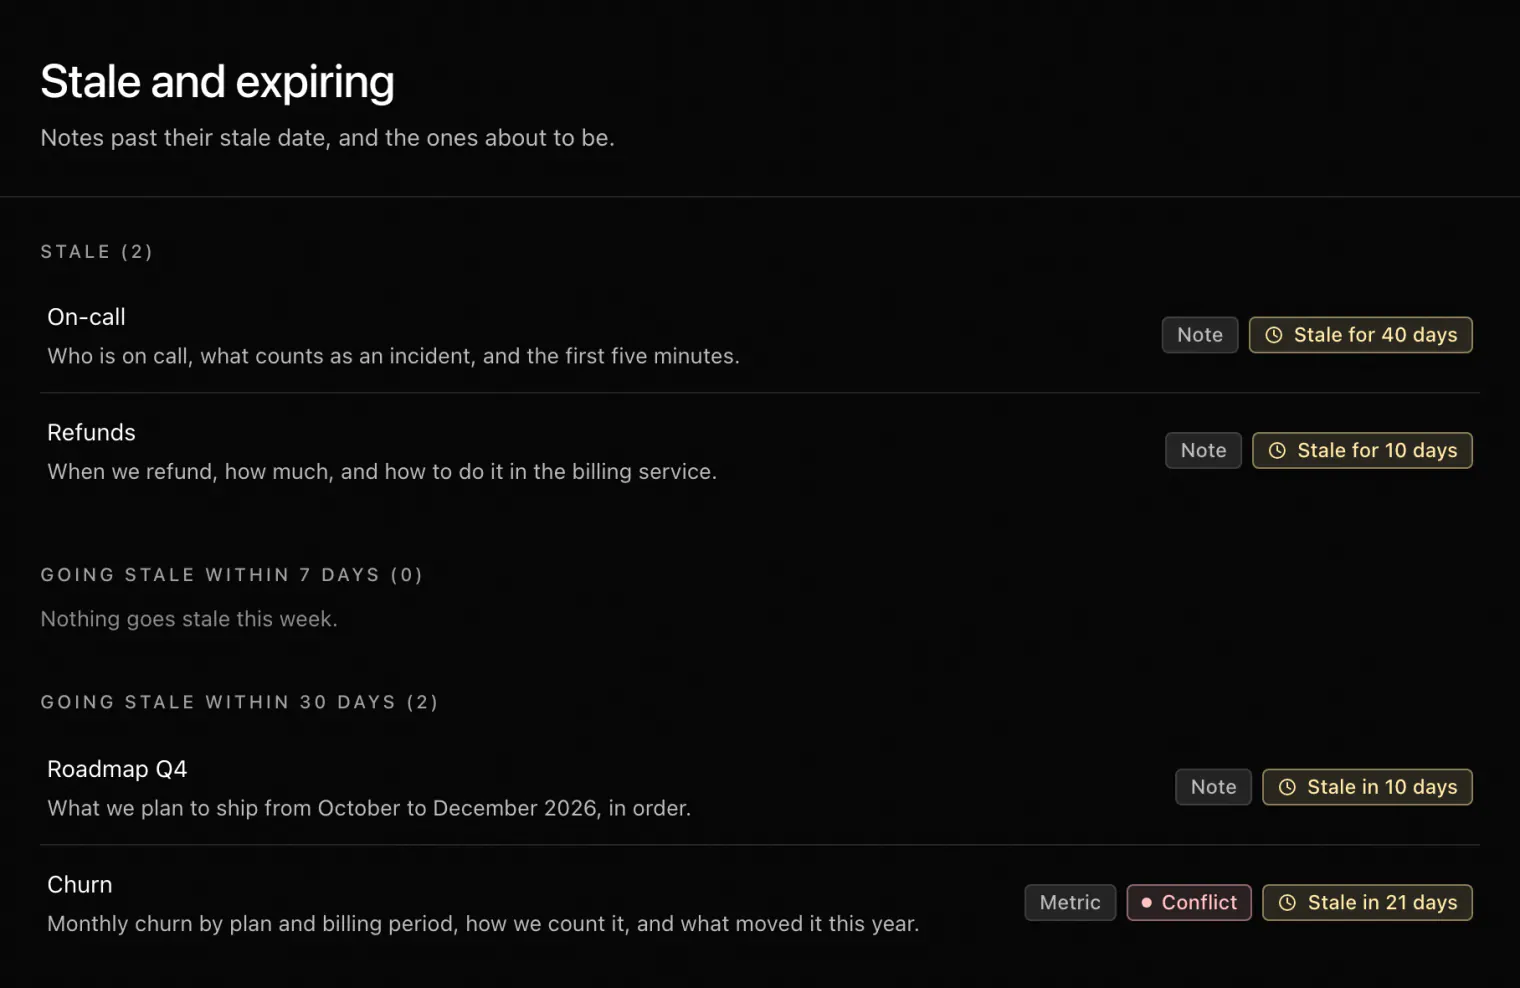
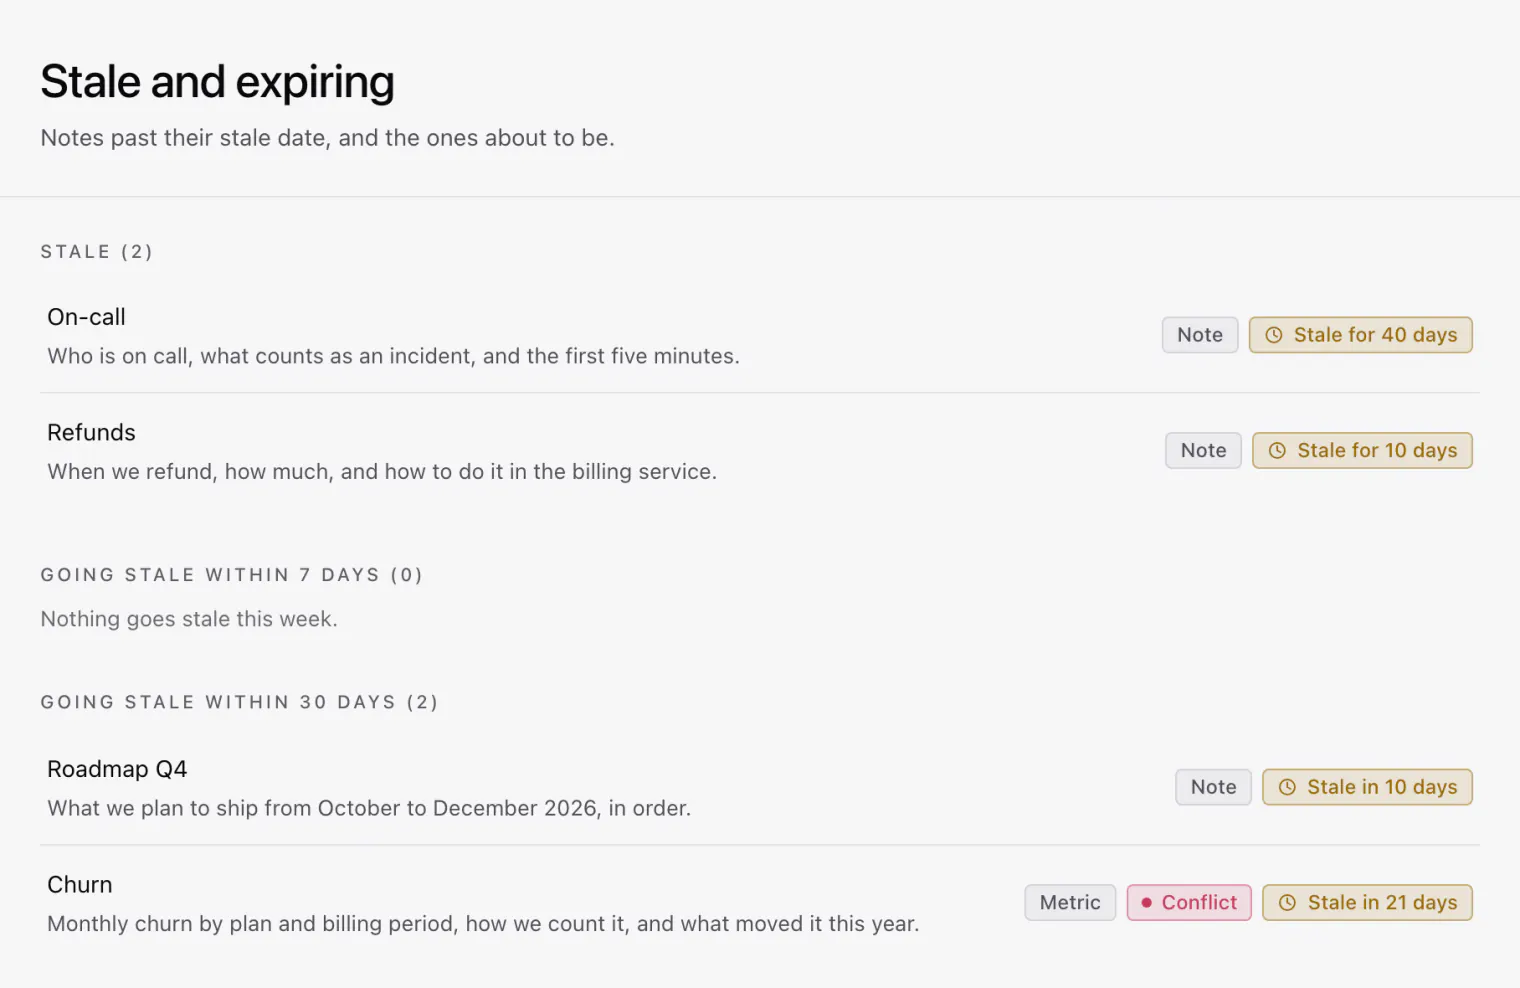
In Knowtarium listet die Seite Stale and expiring die Dokumente, deren stale_after vorbei ist oder bald kommt, und Agenten können dieselbe Liste abrufen, fertig zum erneuten Prüfen.
 (öffnet in voller Größe in einem neuen Tab)
 (öffnet in voller Größe in einem neuen Tab)
8. Gib jedem Agenten denselben Einstieg
Coding-Agenten, die im Repository arbeiten, lesen die Dateien direkt. Chat-Apps ohne Dateizugriff kann ein MCP-Server über dem Ordner die Dokumente auf Anfrage geben. So oder so lesen die Agenten dieselben Dateien, die Menschen prüfen, und es gibt nur eine Version der Wahrheit.
Eine nützliche Regel
Agenten dürfen alles schreiben, aber sie markieren ihre eigene Arbeit nie als von einem Menschen geprüft. Nur ein Mensch trägt einen human:-Eintrag in verified ein. Diese eine Regel hält die Vertrauensstufen ehrlich.
So baust du ein Company Brain mit Knowtarium
Hier derselbe Aufbau mit Knowtarium, am Beispiel der Preisentscheidung von oben. Knowtarium ersetzt deinen Agenten nicht. Es ist der Ort, an dem die Dokumente liegen, Ende-zu-Ende-verschlüsselt, an dem du siehst, was jeder Agent getan hat, und an dem du entscheidest, was als geprüft gilt.
Importier den Ordner company-brain in einen Workspace, verbinde deine Agenten mit und schalte Review für die Ordner ein, in denen es um Geld geht, etwa company/decisions/.
- Lass einen Agenten schreiben und sieh dir an, was sich geändert hat. Bitte den Agenten, aus der Notiz zum Preis-Meeting ein Entscheidungsdokument zu machen. Weil für diesen Ordner Review an ist, wartet es als Diff, als ungeprüft markiert. Lies es, öffne die genannte Meeting-Notiz und gib es frei: Knowtarium trägt dich mit Uhrzeit in
verifiedein. Ist es falsch, lehnst du es mit einem Kommentar ab. In Ordnern ohne Review wird die Änderung sofort gespeichert, vom Agenten signiert und am Dokument markiert, und Undo ist einen Klick entfernt. - Ändere selbst einen Fakt und lass einen Agenten ihn prüfen. Angenommen, der Rabatt für Jahrespläne ändert sich. Du bearbeitest die Entscheidung in Knowtarium, die Änderung wird als deine signiert und wartet auf die Prüfung durch einen Agenten. Bitte deinen Agenten: „Prüf die Änderungen von heute“. Er liest den Diff, folgt Links zu Dokumenten wie
plans-and-limits.mdund korrigiert oder markiert jede Stelle, an der noch die alte Zahl steht. Sobald beide Prüfungen erfasst sind, ist die Entscheidung vollständig verifiziert. - Behalte die Aktualität im Blick. Die Entscheidung läuft am 31. März 2027 ab. Die Seite Stale and expiring listet sie, wenn das Datum näher rückt, und als veraltet, sobald es vorbei ist, bis jemand sie auffrischt. Eine Auffrischung ist eine neue Änderung und bekommt deshalb ihren eigenen zweiten Blick.
- Nimm es mit. Exportier den Workspace oder einen Ordner jederzeit als einfaches Markdown. Die
verified-Einträge reisen mit den Dateien, also sieht jeder, der sie liest, wer was geprüft hat, in jedem Editor.
Was Agenten nicht können
In Knowtarium können Agenten lesen, schreiben, deine Änderungen prüfen und veraltete Dokumente auffrischen, in dem Workspace und den Ordnern, mit denen du sie verbunden hast. Dokumente löschen oder verschieben sie nur, wenn du ihnen das erlaubt hast, sie können nichts als von einem Menschen geprüft markieren, und in Ordnern mit Review können sie deine Prüfung nicht überspringen. Jede ihrer Änderungen ist signiert, lässt sich also immer zurückverfolgen und rückgängig machen.
Ein Company Brain im Team betreiben
Ein Company Brain aus Markdown in Git wird geteilt wie Code: über das Repository. Alle klonen es, Agenten und Menschen bearbeiten Dateien, und Änderungen kommen über Commits und Pull Requests. Git liefert Verlauf, Branches und Merge-Konflikte; dein Git-Host regelt den Zugriff.
An dieser Stelle lohnt es sich, genau zu sagen, was Knowtarium heute kann und was nicht.
- Teilen im Team gibt es noch nicht. Ein Knowtarium-Konto und seine Workspaces gehören einer Person: Es gibt keine geteilten Workspaces, keine Rechte für Mitglieder und kein gemeinsames Bearbeiten in Echtzeit. Geteilte Workspaces sind geplant, aber nicht für die erste Version.
- Teilen kannst du die Dateien. Wenn du in Knowtarium eine Änderung freigibst, kommen dein Name und die Uhrzeit in die
verified-Liste des Dokuments. Exportier den Workspace als einfaches Markdown und leg ihn in ein Repository, dann sieht jeder, der ihn liest, die Prüfung, egal mit welchem Tool er die Datei öffnet. Das ist eine Kopie, keine Live-Verbindung. - Eine Person, mehrere Agenten. Du kannst mehrere Agenten verbinden (Claude Code, Codex, Cursor, Claude Desktop), jeden mit einem Workspace oder nur einigen seiner Ordner, nur lesend oder lesend und schreibend. Jede Änderung zeigt, welcher Agent sie gemacht hat, und wenn du einem den Zugriff entziehst, ist er sofort raus.
- Nicht alle brauchen es. Teammitglieder, die nie prüfen, können die exportierten Dateien in ihrem Editor lesen, sie auf deinem Git-Host ansehen oder ihre Agenten sie lesen lassen.
Wenn du heute einen geteilten Workspace brauchst, Rechte pro Dokument, eine Admin-Konsole oder gemeinsames Bearbeiten in Echtzeit, ist Knowtarium dafür noch nicht ausgelegt. Heute ist es für die Person, die das Brain pflegt und prüft, was Agenten schreiben.
Typische Fehler beim Aufbau eines Company Brains
- Alles einspeisen. Wer jeden Kanal und jedes Postfach ins Brain kippt, begräbt die geklärten Antworten unter der Diskussion. Halte Entscheidungen und Definitionen fest und verlinke das Rohmaterial als Quelle.
- Keine Herkunft. Sobald du nicht mehr erkennst, welche Dokumente ein Agent geschrieben und niemand geprüft hat, musst du allen misstrauen.
- Agenten geben Agenten frei. Ein zweiter Agent, der den ersten bestätigt, ist nützlich, aber er ersetzt keine Prüfung durch einen Menschen. Halte beides getrennt.
- Kein Ablaufdatum. Preise, Zuständige, Limits und Organigramme veralten innerhalb von Monaten. Ohne
stale_aftersehen veraltete Dokumente genauso aus wie aktuelle. - Quellen, die verschwinden. Ein Link auf eine Chatnachricht oder ein Meeting, das niemand aufgezeichnet hat, ist keine Quelle. Speicher die Quelle im Repository (als Meeting-Notiz oder Export) und nenne die Datei.
- Niemand ist zuständig. Jemand muss sich ansehen, was die Agenten geändert haben. Wenn Prüfen die Aufgabe von allen ist, wird es die Aufgabe von niemandem.
Fragen
Was ist ein Company Brain?
Ein Company Brain ist das gemeinsame, schriftliche Gedächtnis darüber, wie eine Firma arbeitet (ihre Entscheidungen, Definitionen, Abläufe und Kunden). Es wird aktuell gehalten und so strukturiert, dass Menschen und KI-Agenten es finden, lesen und ihm vertrauen können.
Was unterscheidet ein Company Brain von einem Wiki?
Ein Wiki pflegen Menschen, und es veraltet gern. Ein Company Brain pflegen größtenteils Agenten: Sie halten neues Wissen fest und aktualisieren bestehende Dokumente, während Menschen die Änderungen prüfen. Außerdem hält es fest, wer jedes Dokument geschrieben hat, wer es geprüft hat, woher die Aussagen stammen und wann es abläuft.
Brauche ich eine Vektordatenbank für ein Company Brain?
Nein. Du kannst ein Company Brain als Markdown-Dateien in einem Git-Repository führen, die Coding-Agenten wie Claude Code, Codex und Cursor direkt lesen. Eine Vektordatenbank hilft bei riesigen Sammlungen, aber Menschen können sie kaum lesen oder prüfen.
Wie verhindere ich, dass KI-Agenten ein Company Brain mit falschen Infos füllen?
Halte fest, wer jedes Dokument geschrieben hat, verlange für jede Aussage eine Quelle, gib Fakten, die sich schnell ändern, ein Ablaufdatum, und lass einen Menschen jede Änderung eines Agenten prüfen, bevor man ihr vertraut. Lass einen Agenten nie seine eigene Arbeit als von einem Menschen geprüft markieren.
Kann ein Team Knowtarium als gemeinsames Company Brain nutzen?
Noch nicht. Heute gehören ein Knowtarium-Konto und seine Workspaces einer Person: Es gibt keine geteilten Workspaces, keine Rechte für Mitglieder und keine Zusammenarbeit in Echtzeit. Du kannst einen Workspace aber jederzeit als einfache OKF-Markdown-Dateien exportieren und diese teilen, zum Beispiel in einem Git-Repository.