Explicación
Cerebro de empresa: qué es y cómo crear uno para agentes de IA
Un cerebro de empresa (company brain) es la memoria compartida de cómo funciona tu empresa, al día y con una estructura que permite que tanto las personas como los agentes de IA la lean y se fíen de ella. Aquí verás qué tiene que hacer, cómo se comparan los enfoques habituales y cómo crear uno con documentos markdown que mantienen tus agentes, con Knowtarium para controlar lo que escriben.
Por Fadel Kaadan · Actualizado el
¿Qué es un cerebro de empresa?
Un cerebro de empresa (en inglés, company brain) es la memoria compartida y escrita de cómo funciona una empresa: sus decisiones, definiciones, procesos, clientes y lecciones aprendidas, al día y con una estructura que permite que tanto las personas como los agentes de IA la encuentren, la lean y se fíen de ella.
Es la respuesta a preguntas como “¿qué cuenta aquí como cliente activo?”, “¿por qué quitamos el plan gratuito?” o “¿quién se encarga de la exportación de facturación?”. Esas respuestas suelen estar en la cabeza de alguien, en un hilo de chat de la primavera pasada y en tres páginas de la wiki que se contradicen. Un cerebro de empresa pone una sola respuesta actual en un solo sitio y deja constancia de dónde salió.
Algunas cosas que un cerebro de empresa no es:
- No es un modelo. El cerebro es el conocimiento. El chatbot o el agente que responde preguntas a partir de él es una interfaz por encima.
- No es un montón de todo. Indexar cada correo y cada mensaje de chat te da búsqueda, no memoria. Un cerebro guarda la versión destilada: la decisión, no los 200 mensajes que llevaron a ella.
- No es una app de notas personales. Un segundo cerebro sirve al pensamiento de una persona. Un cerebro de empresa es compartido, así que la precisión, la responsabilidad y la revisión importan más que la rapidez al capturar.
En Knowtarium
Knowtarium es una base de conocimiento cifrada de extremo a extremo que personas y agentes de IA escriben juntos, hecha para este tipo de cerebro: documentos markdown en espacios de trabajo y carpetas, y cada uno muestra quién lo escribió (y, en las carpetas con revisión activada, quién lo revisó). Empezar es gratis. Por ahora, un espacio de trabajo pertenece a una sola persona; compartirlo con un equipo todavía no es posible.
Por qué el término se ha popularizado
Las empresas quieren una única fuente de verdad desde que existen las wikis. Lo que ha cambiado es quién la lee. Los agentes de IA ya escriben código, atienden a clientes, redactan informes y hacen análisis, y todos necesitan contexto de la empresa para hacerlo bien.
Una persona se las arregla cuando le falta contexto: pregunta a un compañero, recuerda el trimestre pasado, nota que una cifra no cuadra. Un agente no hace nada de eso. Sabe lo que hay en su ventana de contexto y nada más, y la mayoría de los agentes empiezan cada sesión desde cero. La documentación de Claude Code lo dice claramente: cada sesión empieza con una ventana de contexto nueva, y lo que se conserva es lo que está escrito en archivos, como CLAUDE.md o AGENTS.md. Si el contexto no está escrito, el agente adivina.
La segunda razón es que las wikis se degradan. La nota LLM Wiki de Andrej Karpathy, publicada en abril de 2026, resume el problema en una frase:
“Las personas abandonan las wikis porque el esfuerzo de mantenerlas crece más rápido que su valor.”
Su propuesta: que el modelo se encargue del mantenimiento. Un agente lee las fuentes originales, escribe y actualiza páginas markdown enlazadas entre sí y, de vez en cuando, las revisa en busca de contradicciones, afirmaciones desfasadas y páginas huérfanas. Las personas seleccionan y hacen preguntas. Esa idea, que los agentes mantengan el conocimiento en lugar de solo buscar en él, es lo que distingue un cerebro de empresa de la wiki que ya tienes. (Nuestra guía sobre la LLM wiki explica el patrón paso a paso.)
A partir de ahí el término se extendió, y hoy abarca tanto wikis alojadas con búsqueda por IA como proyectos de código abierto que guardan la memoria de un agente como archivos markdown en git. En lo que más se diferencian es en la pregunta que la nota de Karpathy deja a las personas: quién revisa lo que escribieron los agentes.
Qué tiene que hacer un cerebro de empresa
Uses la herramienta que uses, un cerebro de empresa tiene cuatro tareas. La mayoría de los sistemas cumplen razonablemente bien las tres primeras. La cuarta es donde más se diferencian, y de ella depende que alguien se fíe de las respuestas.
1. Capturar lo que importa
El conocimiento tiene que entrar sin que una persona lo copie a mano: notas de reuniones, decisiones, patrones de soporte, informes de incidencias, cambios de precios o de procesos. En la práctica, esto significa agentes que leen el material original y escriben o actualizan el documento correspondiente.
2. Mantenerse al día
Un cerebro que tenía razón en marzo es peligroso en septiembre, porque suena igual de seguro. Cada dato que puede cambiar necesita una fecha a partir de la cual alguien vuelve a comprobarlo, y una forma de encontrar todo lo que depende de ese dato cuando cambia.
3. Poder consultarse por personas y agentes
Las personas necesitan explorarlo y buscar en él. Los agentes necesitan leerlo sin una integración especial para cada herramienta: texto plano, una estructura predecible y descripciones breves que puedan repasar antes de abrir un documento entero.
4. Ser fiable
Cuando los agentes escriben gran parte del contenido, cada documento tiene que responder a primera vista cuatro preguntas:
- ¿Quién lo escribió? ¿Una persona o un agente (y cuál)?
- ¿Quién lo revisó? ¿Lo ha revisado una persona, solo otro agente o nadie?
- ¿De dónde sale? ¿Qué fuente respalda cada afirmación?
- ¿Sigue siendo cierto? ¿Cuándo se confirmó por última vez y cuándo caduca?
Sin esto, el cerebro se va llenando poco a poco de texto verosímil que nadie ha comprobado, y la gente deja de fiarse de todo. Una respuesta de IA que cita un documento sin revisar de hace un año es peor que no tener respuesta, porque parece autorizada.
En Knowtarium
Aparte de un web clipper que guarda enlaces, Knowtarium deja la captura a tus agentes y se centra en la cuarta tarea. Quién escribió un documento, de dónde sale y cuándo caduca aparece en la parte superior de la página, y los documentos con la fecha vencida se listan en la página Stale and expiring. En las carpetas con revisión activada, la página también muestra quién lo revisó, y el grafo puede colorear los documentos por nivel de confianza (unverified, machine-confirmed o human-reviewed). Las personas buscan en el texto completo desde la app, y los agentes leen los mismos documentos por MCP.
Tres formas de crear un cerebro de empresa
Wiki alojada con búsqueda por IA
La vía más habitual: mantener (o adoptar) una base de conocimiento alojada y añadir una capa de IA que busque en ella y en tus otras herramientas. Los productos de esta categoría se diferencian por su alcance y por cuánto puede cambiar su IA:
- Búsqueda empresarial. Se conecta a cientos de apps de trabajo (chat, unidades compartidas, gestores de incidencias, CRM) y responde preguntas sobre todas ellas, mostrando a cada usuario solo lo que tiene permiso para ver.
- Wikis con asistente integrado. Responden preguntas a partir de la wiki y de algunas apps conectadas, y permiten que sus agentes creen y editen páginas.
- Wikis que se mantienen solas. Vigilan tus otras herramientas, redactan una actualización cuando una página se queda desfasada y la envían a una persona para que la apruebe.
Puntos fuertes: permisos, incorporación de equipos no técnicos, búsqueda en todo a la vez, ninguna configuración para la mayoría de la gente. Puntos débiles: el conocimiento vive en la base de datos de un proveedor, y los agentes de código que trabajan en un repositorio suelen llegar a él a través de una API o un servidor MCP en lugar de leerlo directamente. Además, buscar en las fuentes originales encuentra el hilo de chat contradictorio con la misma facilidad que la respuesta acordada.
Base de datos vectorial y RAG
Los equipos de ingeniería suelen construir el suyo: dividen los documentos en fragmentos, generan sus embeddings, guardan los vectores y recuperan los fragmentos más cercanos al hacer la pregunta (generación aumentada por recuperación). Es flexible y escala a corpus enormes.
Puntos fuertes: colecciones grandes que cambian rápido; pipelines a medida. Puntos débiles: nadie puede leer una base de datos vectorial. Las contradicciones conviven una junto a otra, la recuperación devuelve el fragmento con mejor puntuación y no hay un lugar natural para anotar quién revisó un dato o cuándo caduca. Al final acabas construyendo una capa de revisión encima de todos modos.
Archivos markdown en git, que los agentes leen directamente
El enfoque al que llegaron por su cuenta los equipos de desarrollo: el conocimiento es una carpeta de archivos markdown en un repositorio. Claude Code, Codex, Cursor y otros agentes leen y editan los archivos con las mismas herramientas que usan para el código. Un archivo de convenciones (AGENTS.md, un formato abierto que, según agents.md, admiten Codex, Cursor y muchos otros agentes de código, o el CLAUDE.md de Claude Code) les dice cómo está organizada la carpeta. Esta es la forma de la LLM wiki de Karpathy.
Puntos fuertes: los agentes pueden leerlo y mantenerlo sin integración alguna, cada cambio es un diff que puedes revisar, git te da historial y blame gratis, y nada queda atado a un proveedor. Puntos débiles: no hay más permisos que los del repositorio, no hay un editor pulido para compañeros no técnicos, y git por sí solo no te dice qué documentos ha revisado una persona.
| Wiki alojada + búsqueda por IA | Base vectorial / RAG | Markdown en git | |
|---|---|---|---|
| Dónde vive el conocimiento | En la nube del proveedor | En tu base de datos, como vectores | En archivos de texto que son tuyos |
| Cómo lo leen los agentes | API, MCP o asistente integrado | Tu código de recuperación | El sistema de archivos |
| Los agentes escriben en él | Depende del producto | A través de tu pipeline de ingesta | Sí, como al editar código |
| Revisión de cambios | Varía según el producto | La construyes tú | Diffs, pull requests |
| Permisos | Por usuario, por documento | Los construyes tú | Por repositorio |
| Ideal para | Organizaciones grandes o no técnicas | Corpus enormes, productos a medida | Equipos cuyo trabajo ya pasa por agentes y git |
Ninguno es incorrecto. Si tienes cientos de empleados, reglas de acceso estrictas y poca gente que abra una terminal, una wiki alojada te servirá mejor. El resto de esta página trata del tercer enfoque, porque es el que deja el mantenimiento a los agentes. Knowtarium se basa en él: los mismos documentos markdown y el mismo frontmatter, en un espacio de trabajo cifrado de extremo a extremo al que tus agentes acceden por MCP.
Cómo crear un cerebro de empresa con archivos markdown que mantienen tus agentes
Puedes empezar en una tarde con un repositorio git y el agente de código que ya usas. Los pasos siguientes siguen el Open Knowledge Format (OKF), una especificación abierta publicada por Google Cloud (v0.2 en GitHub) para el conocimiento en markdown que escriben los agentes. El formato no depende de ninguna herramienta, y mientras solo una o dos personas toquen la carpeta, los diffs de git y un ojo atento pueden bastar. En la mayoría de los pasos se indica qué añade Knowtarium.
1. Empieza por un área problemática
No intentes capturar toda la empresa. Elige las preguntas que más se hacen o que peor se responden: precios y límites de los planes, definiciones de métricas, el proceso de lanzamiento, los runbooks de guardia. Un cerebro que acierta en diez cosas es mejor que uno que acierta más o menos en mil.
2. Crea el repositorio y una estructura de carpetas
Un concepto por archivo, agrupados en carpetas que tengan sentido para tu equipo:
company-brain/AGENTS.md # las reglas que siguen los agentes en esta carpetaindex.md # qué hay aquí, una línea por documentolog.md # qué ha cambiado, lo más reciente primerocompany/glossary.md # qué entendemos por 'cliente activo', 'churn', 'MRR'decisions/2026-08-pricing.md # una decisión por archivo, con su porquéproduct/plans-and-limits.mdrelease-process.mdmeetings/2026-08-14-pricing-review.mdcustomers/segments.mdaccounts/northwind.mdrunbooks/refunds.mdon-call.md
index.md y log.md son nombres reservados en OKF: el primero enumera lo que contiene una carpeta y el segundo registra lo que ha cambiado. Los agentes leen primero el índice, así que solo abren los documentos que necesitan.
En Knowtarium
Importa esta carpeta a un espacio de trabajo de Knowtarium y ya es un paquete OKF tal como está: las carpetas se mantienen, y los documentos a los que les faltan campos se abren igualmente. El grafo, la búsqueda y la vista de propiedades funcionan sobre los mismos documentos que editan tus agentes.
3. Escribe las reglas para tus agentes
Pon las convenciones en AGENTS.md (y haz que CLAUDE.md apunte a él si usas Claude Code). Que sea breve y concreto. Nuestra guía sobre AGENTS.md para bases de conocimiento tiene una versión más completa.
# Reglas de esta base de conocimiento- Un concepto por archivo. Busca antes de crear; si ya existe, actualiza ese archivo.- Cada archivo empieza con frontmatter: type, title, description.- Cuando escribas o cambies un archivo, pon en generated.by tu nombre de agente y tu versión.- Nunca te añadas a ti ni a nadie a verified. Eso solo lo hacen los revisores.- Cada afirmación factual cita una fuente con una nota al pie: [^source-id].- Pon una fecha stale_after a los datos que cambian rápido (precios, responsables, límites).- Enlaza los documentos relacionados con enlaces markdown desde la raíz del paquete: [Churn](/metrics/churn.md).- Añade una línea a log.md por cada cambio: fecha, archivo, qué y por qué.
En Knowtarium
Conecta Claude Code, Codex o Cursor con y Knowtarium le da las convenciones básicas junto con sus herramientas: leer primero el index.md propio del espacio de trabajo, si lo tiene, leer las descripciones antes que los documentos enteros y no marcar nunca nada como revisado por una persona. Cada cambio que hace va firmado con su propia clave. Escribe tu AGENTS.md en el propio espacio de trabajo, para todo el espacio o para una carpeta, y cada agente conectado lo sigue en cada documento que escribe allí.
4. Registra la procedencia en cada documento
El frontmatter es lo que hace fiable al cerebro. OKF define campos justo para las cuatro preguntas de antes: generated (quién lo escribió y cuándo), verified (quién lo revisó), sources (de dónde salen las afirmaciones) y stale_after (cuándo hay que volver a revisarlo).
---type: Decisiontitle: Los planes anuales tienen dos meses gratisdescription: Por qué el precio anual es 10 veces el mensual, y cuándo revisarlo.status: stablegenerated: { by: claude-code/2.1, at: 2026-09-20T09:12:00Z }verified:- { by: human:sara, at: 2026-09-21T14:30:00Z }stale_after: 2027-03-31T00:00:00Zsources:- id: pricing-reviewresource: /meetings/2026-08-14-pricing-review.mdauthor: human:sara---Los planes anuales cuestan diez veces el precio mensual.[^pricing-review]Lo revisamos al final del primer trimestre, cuando tengamos las cifras de churn.
Los actores se nombran con un formato fijo: un agente con su versión (claude-code/2.1), una persona (human:sara) o un proceso (process:billing-sync). Así, quien lo lee puede deducir el nivel de confianza de un documento a partir de la lista verified en lugar de fiarse de una etiqueta. Consulta cómo hacer que los agentes citen sus fuentes para la convención de las notas al pie.
En Knowtarium
Knowtarium muestra este frontmatter como propiedades en la parte superior del documento en lugar de YAML en bruto. Tus propias claves, como un campo owner, se conservan exactamente como las escribiste.
5. Llénalo con lo que ya tienes
Dirige a un agente a la exportación de tu wiki actual, a tus notas de reuniones o a una carpeta de decisiones y pídele que escriba un documento por concepto, citando el archivo de origen de cada afirmación. Cuenta con duplicados y contradicciones en la primera pasada. Es útil: te muestran dónde tu documentación actual se contradice a sí misma.
En Knowtarium
Cada documento que el agente escribe durante esta carga inicial va firmado con su nombre y no tiene ninguna entrada en verified hasta que alguien lo revisa, así que nunca pasan por documentos revisados, y cualquiera de ellos se puede deshacer. Si tus notas están en una bóveda de Obsidian, impórtala a un espacio de trabajo y se convierte a OKF sin tocar lo que escribiste.
6. Revisa cada cambio antes de que alguien dependa de él
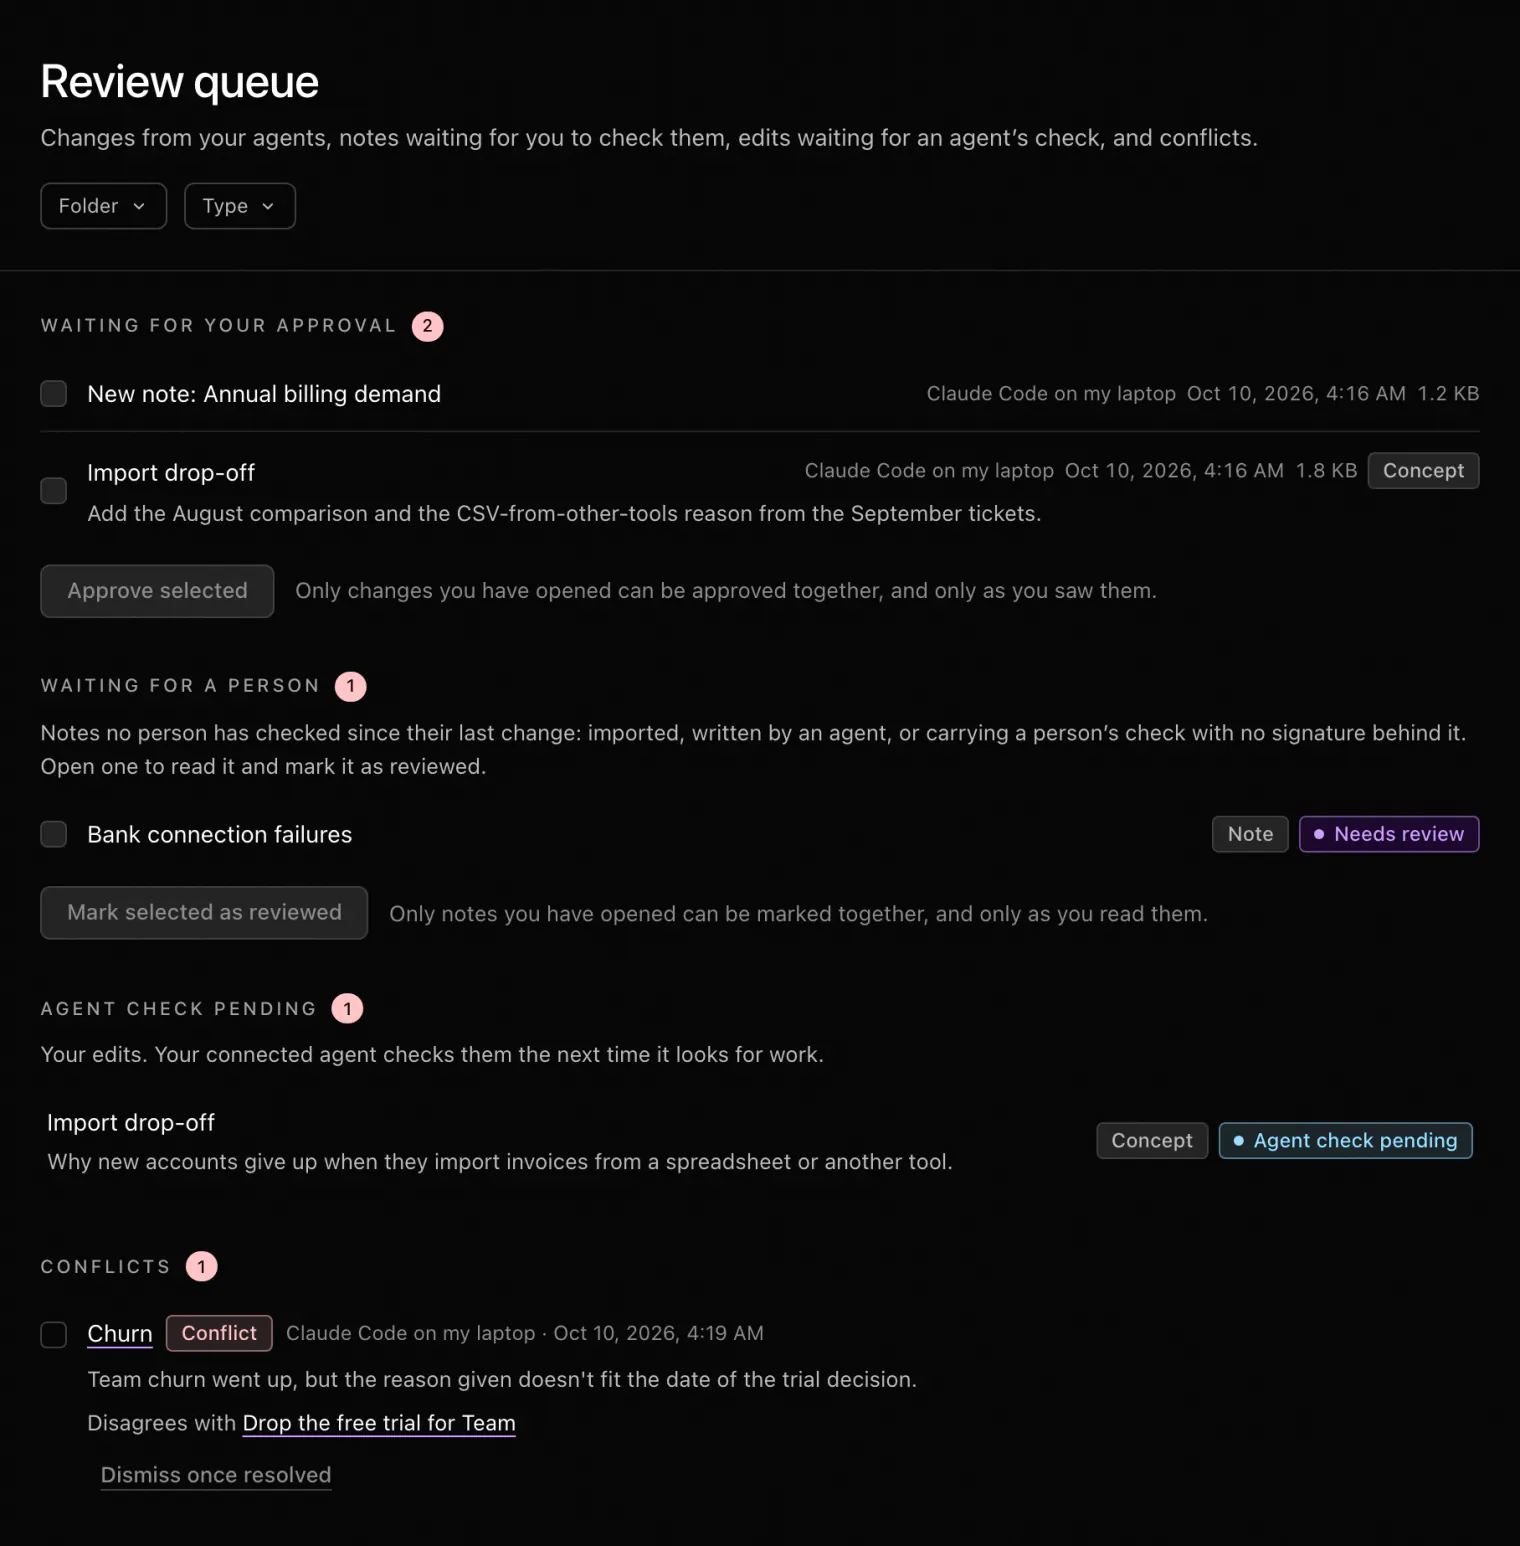
Este es el paso que la mayoría de los equipos se salta, y el que importa. Los agentes deberían abrir un pull request (o dejar los cambios sin hacer commit) en lugar de escribir directamente en la rama principal. Una persona lee el diff, comprueba la fuente citada y añade su propia entrada en verified cuando todo es correcto. La guía sobre cómo revisar las ediciones de los agentes explica en qué fijarse.
También funciona en sentido contrario. Cuando una persona edita un documento a mano, por ejemplo para cambiar un precio, los demás documentos que mencionan el precio antiguo pasan a estar mal. Pide a un agente que compare cada documento relacionado con la edición y proponga correcciones.
En Knowtarium
Knowtarium hace las dos cosas allí donde activas la revisión (“Ask me first”, por espacio de trabajo o por carpeta). Ahí, el cambio de un agente queda pendiente como un diff hasta que lo apruebas, lo que te añade a verified. Tu propia edición espera hasta que pides a un agente que la revise (“revisa las ediciones de hoy”), y un documento que ambas partes han revisado desde su último cambio queda totalmente verificado. En todos los demás sitios, los cambios de los agentes se guardan al instante, firmados y se pueden deshacer.
 (se abre a tamaño completo en una pestaña nueva)
 (se abre a tamaño completo en una pestaña nueva)
7. Programa la revisión de la vigencia
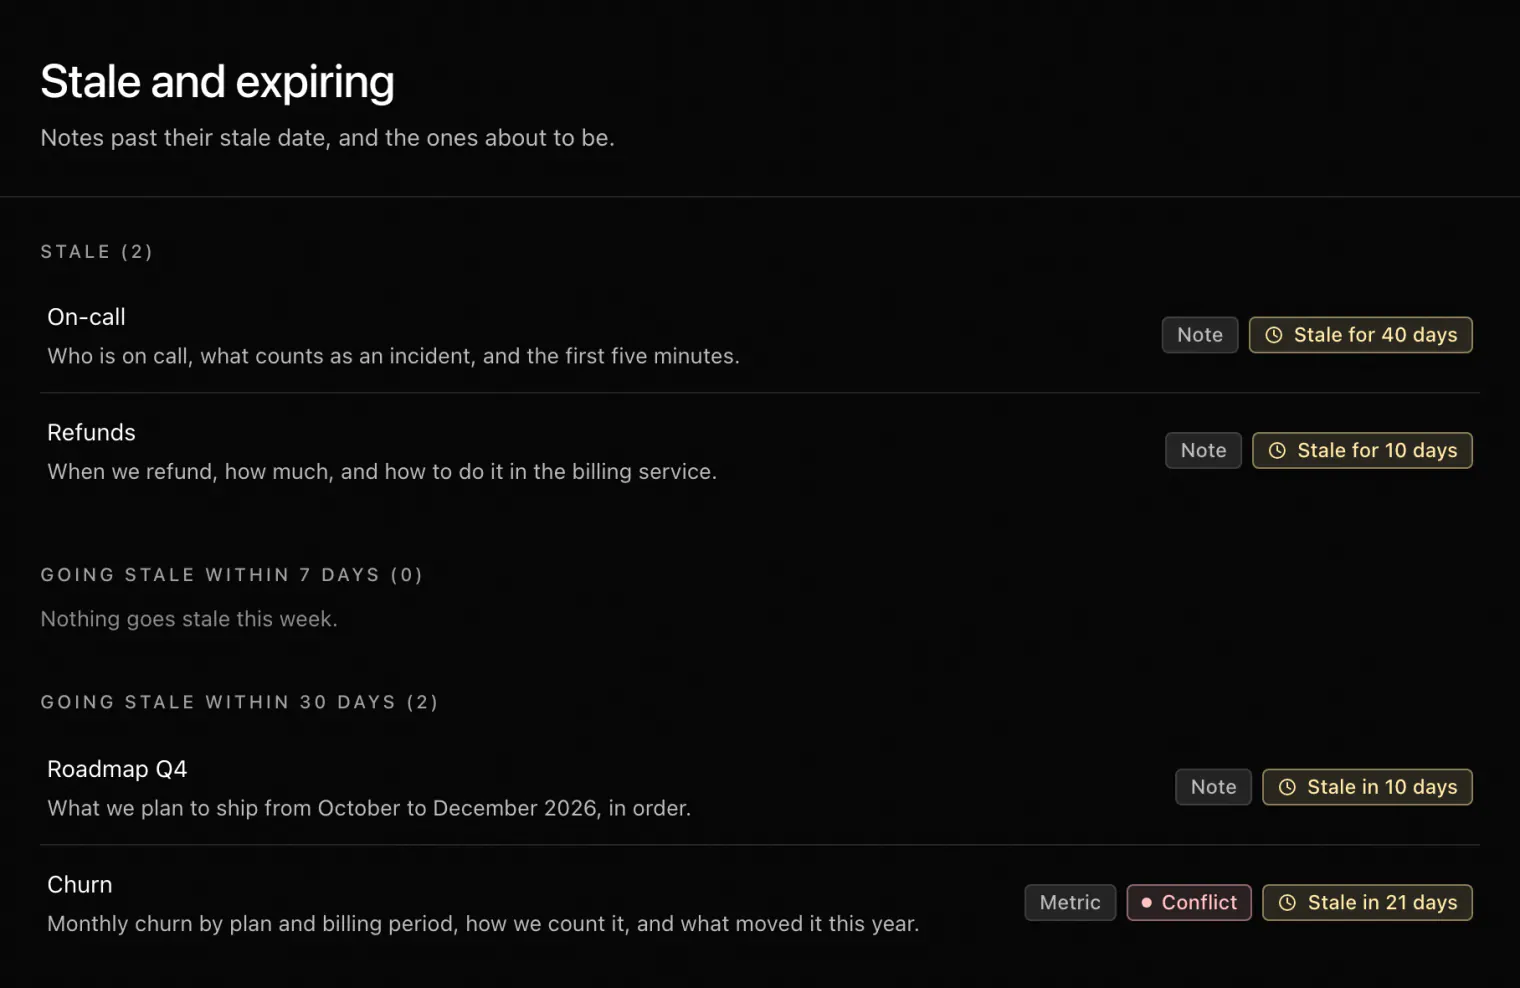
Todo lo que pueda desviarse recibe una fecha stale_after. Una vez a la semana, pide a un agente que liste los documentos con la fecha vencida o a punto de vencer, los vuelva a comprobar con sus fuentes y proponga actualizaciones. Los documentos que nadie vuelve a comprobar se marcan como status: deprecated en lugar de dejarlos ahí induciendo a error.
En Knowtarium
En Knowtarium, la página Stale and expiring lista los documentos que han pasado su stale_after y los que vencen pronto, y los agentes pueden pedir la misma lista, lista para volver a comprobarla.
 (se abre a tamaño completo en una pestaña nueva)
 (se abre a tamaño completo en una pestaña nueva)
8. Da a todos los agentes el mismo punto de entrada
Los agentes de código que trabajan en el repositorio leen los archivos directamente. Para las apps de chat sin acceso a archivos, un servidor MCP sobre la carpeta puede darles los documentos cuando los pidan. En ambos casos, los agentes leen los mismos archivos que revisan las personas, así que hay una sola versión de la verdad.
Una regla útil
Los agentes pueden escribir lo que sea, pero nunca marcan su propio trabajo como revisado por una persona. Solo una persona añade una entrada human: a verified. Esa única regla mantiene honestos los niveles de confianza.
Cómo crear un cerebro de empresa con Knowtarium
Este es el mismo proceso con Knowtarium de por medio, siguiendo la decisión de precios del ejemplo anterior. Knowtarium no sustituye a tu agente. Es donde viven los documentos, cifrados de extremo a extremo, donde ves lo que ha hecho cada agente y donde decides qué cuenta como revisado.
Importa la carpeta company-brain a un espacio de trabajo, conecta tus agentes con y activa la revisión en las carpetas que deciden sobre dinero, como company/decisions/.
- Deja que un agente escriba y luego mira qué ha cambiado. Pide al agente que convierta la nota de la reunión de precios en un documento de decisión. Como esa carpeta tiene la revisión activada, el cambio queda pendiente como un diff, marcado como no verificado. Léelo, abre la nota de la reunión citada y apruébalo: Knowtarium te añade a
verifiedcon la hora. Si está mal, recházalo con un comentario. En las carpetas sin revisión, el cambio se guarda al instante, firmado por el agente y marcado en el documento, con Undo a un clic. - Edita tú un dato y pide a un agente que lo revise. Supón que cambia el descuento anual. Editas la decisión en Knowtarium, el cambio queda firmado como tuyo y espera la revisión de un agente. Dile a tu agente “revisa las ediciones de hoy”: lee el diff, sigue los enlaces a documentos como
plans-and-limits.mdy corrige o señala cada sitio donde siga apareciendo la cifra antigua. Una vez registradas las dos revisiones, la decisión queda totalmente verificada. - Vigila la vigencia. La decisión caduca el 31 de marzo de 2027. La página Stale and expiring la muestra a medida que se acerca la fecha, y como desfasada una vez pasada, hasta que alguien la actualiza. Una actualización es un cambio nuevo, así que recibe su propia segunda revisión.
- Llévatelo contigo. Exporta el espacio de trabajo o una carpeta como markdown plano cuando quieras. Las entradas
verifiedviajan con los archivos, así que cualquiera que los lea ve quién revisó qué, en cualquier editor.
Lo que los agentes no pueden hacer
En Knowtarium, los agentes pueden leer, escribir, revisar tus ediciones y actualizar documentos desfasados, en el espacio de trabajo y las carpetas a los que los conectaste. Solo borran o mueven documentos si les diste ese permiso, no pueden marcar nada como revisado por una persona y, en las carpetas con revisión activada, no pueden saltarse tu revisión. Cada cambio que hacen va firmado, así que siempre se puede rastrear y deshacer.
Llevar un cerebro de empresa en equipo
Un cerebro de empresa en markdown dentro de git se comparte igual que el código: a través del repositorio. Todos lo clonan, agentes y personas editan archivos, y los cambios llegan mediante commits y pull requests. Git aporta el historial, las ramas y los conflictos de fusión; tu plataforma de git aporta el control de acceso.
Aquí también conviene ser preciso sobre lo que Knowtarium hace y no hace hoy.
- Compartir en equipo todavía no es posible. Una cuenta de Knowtarium y sus espacios de trabajo pertenecen a una sola persona: no hay espacios de trabajo compartidos, permisos de miembros ni edición conjunta en tiempo real. Los espacios de trabajo compartidos están previstos, pero no para la primera versión.
- Lo que puedes compartir son los archivos. Cuando apruebas un cambio en Knowtarium, tu nombre y la hora entran en la lista
verifiedde ese documento. Exporta el espacio de trabajo como markdown plano y ponlo en un repositorio, y todo el que lo lea verá la revisión, abra el archivo con la herramienta que lo abra. Es una copia, no un enlace en vivo. - Una persona, varios agentes. Puedes conectar varios agentes (Claude Code, Codex, Cursor, Claude Desktop), cada uno a un espacio de trabajo o solo a algunas de sus carpetas, con acceso de solo lectura o de lectura y escritura. Cada cambio muestra qué agente lo hizo, y revocar uno le corta el acceso al instante.
- No todo el mundo lo necesita. Los compañeros que nunca revisan pueden leer los archivos exportados en su editor, verlos en tu plataforma de git o dejar que sus agentes los lean.
Si hoy necesitas un espacio de trabajo compartido, permisos por documento, una consola de administración o edición conjunta en vivo, Knowtarium todavía no está hecho para eso. Hoy es para la persona que mantiene el cerebro y revisa lo que escriben los agentes.
Errores habituales al crear un cerebro de empresa
- Ingerirlo todo. Volcar cada canal y cada bandeja de entrada en el cerebro entierra las respuestas acordadas bajo la discusión. Captura decisiones y definiciones, y enlaza el material original como fuente.
- Sin procedencia. En cuanto no puedes saber qué documentos escribió un agente sin que nadie los revisara, tienes que desconfiar de todos.
- Agentes que aprueban a agentes. Que un segundo agente confirme al primero es útil, pero no es la revisión de una persona. Mantén las dos cosas separadas.
- Sin fechas de caducidad. Los precios, los responsables, los límites y los organigramas se quedan desfasados en meses. Sin
stale_after, los documentos desfasados parecen exactamente iguales que los actuales. - Citar cosas que desaparecen. Un enlace a un mensaje de chat o a una reunión que nadie grabó no es una fuente. Guarda la fuente en el repositorio (como nota de reunión o exportación) y cita el archivo.
- Sin responsable. Alguien tiene que mirar lo que cambiaron los agentes. Si revisar es tarea de todos, acaba siendo tarea de nadie.
Preguntas
¿Qué es un cerebro de empresa (company brain)?
Un cerebro de empresa es la memoria compartida y escrita de cómo funciona una empresa (sus decisiones, definiciones, procesos y clientes), al día y con una estructura que permite que tanto las personas como los agentes de IA la encuentren, la lean y se fíen de ella.
¿En qué se diferencia un cerebro de empresa de una wiki?
Una wiki la mantienen personas y tiende a quedarse desfasada. Un cerebro de empresa lo mantienen sobre todo agentes, que capturan conocimiento nuevo y actualizan los documentos existentes, mientras las personas revisan los cambios. Además, registra quién escribió cada documento, quién lo revisó, de dónde salen las afirmaciones y cuándo caduca.
¿Necesito una base de datos vectorial para crear un cerebro de empresa?
No. Puedes tener un cerebro de empresa como archivos markdown en un repositorio git, que agentes de código como Claude Code, Codex y Cursor leen directamente. Una base de datos vectorial ayuda con colecciones enormes, pero a las personas les cuesta leerla o revisarla.
¿Cómo evito que los agentes de IA llenen un cerebro de empresa de información errónea?
Registra quién escribió cada documento, exige una fuente para cada afirmación, pon fecha de caducidad a los datos que cambian rápido y haz que una persona revise cada cambio de un agente antes de darlo por bueno. Nunca dejes que un agente marque su propio trabajo como revisado por una persona.
¿Puede un equipo usar Knowtarium como cerebro de empresa compartido?
Todavía no. Hoy, una cuenta de Knowtarium y sus espacios de trabajo pertenecen a una sola persona: no hay espacios de trabajo compartidos, permisos de miembros ni colaboración en tiempo real. Puedes exportar un espacio de trabajo como archivos markdown OKF planos cuando quieras y compartirlos, por ejemplo en un repositorio git.